Observando um agente trabalhar: observabilidade e avaliações no Lukre
Como adicionei observabilidade de LLMs e um laboratório de avaliação ao Lukre: rastreamento, privacidade, custos de modelos e os limites dos primeiros resultados.
No final de Construindo o Lukre, escrevi que o próximo passo real era medir. A aplicação tinha testes. O modelo tinha instruções e verificações. E eu só podia esperar que mudar um prompt ou modelo melhorasse as coisas.
Esta é a continuação. Adicionei observabilidade e um laboratório de avaliação ao Lukre, o assistente de finanças domésticas no WhatsApp que roda em produção com famílias reais.
Eu queria responder a cinco perguntas: está correto, qual é a precisão, quanto o membro espera, quanto custa e o que falha? Uma regra vinha antes de todas: a produção não pode piorar. Nenhuma resposta pode esperar por um fornecedor de observabilidade.
Aqui está o que construí, as decisões por trás e o que os números mostraram, dentro dos seus limites.
O plugin que veio junto
O Hermes, ambiente de agentes por trás do Lukre, inclui um plugin do Langfuse. Ativá-lo exigiria uma linha de configuração.
Mas, antes de colocar qualquer coisa no caminho de uma resposta, li seu código na versão exata que fixamos. Havia três problemas:
- Bloqueia a resposta. Ao final de cada turno, envia os dados ao Langfuse de forma síncrona. Se ele estiver lento, o agente espera, até o timeout padrão de 30 segundos dos hooks do Hermes.
- Pode bloquear ferramentas. Registra um hook antes de cada chamada de ferramenta que, no Hermes, falha fechado: se travar, bloqueia a ferramenta.
- Não mascara nada. O modo “sanitizado” remove segredos, não dados pessoais, e a taxa de amostragem é lida só na inicialização.
Nada disso é um defeito numa demonstração. Numa conversa de WhatsApp com pessoas reais, os três são. Escrevi meu próprio coletor com uma regra simples: a telemetria observa, nunca participa.
Um pipeline fora do caminho da resposta
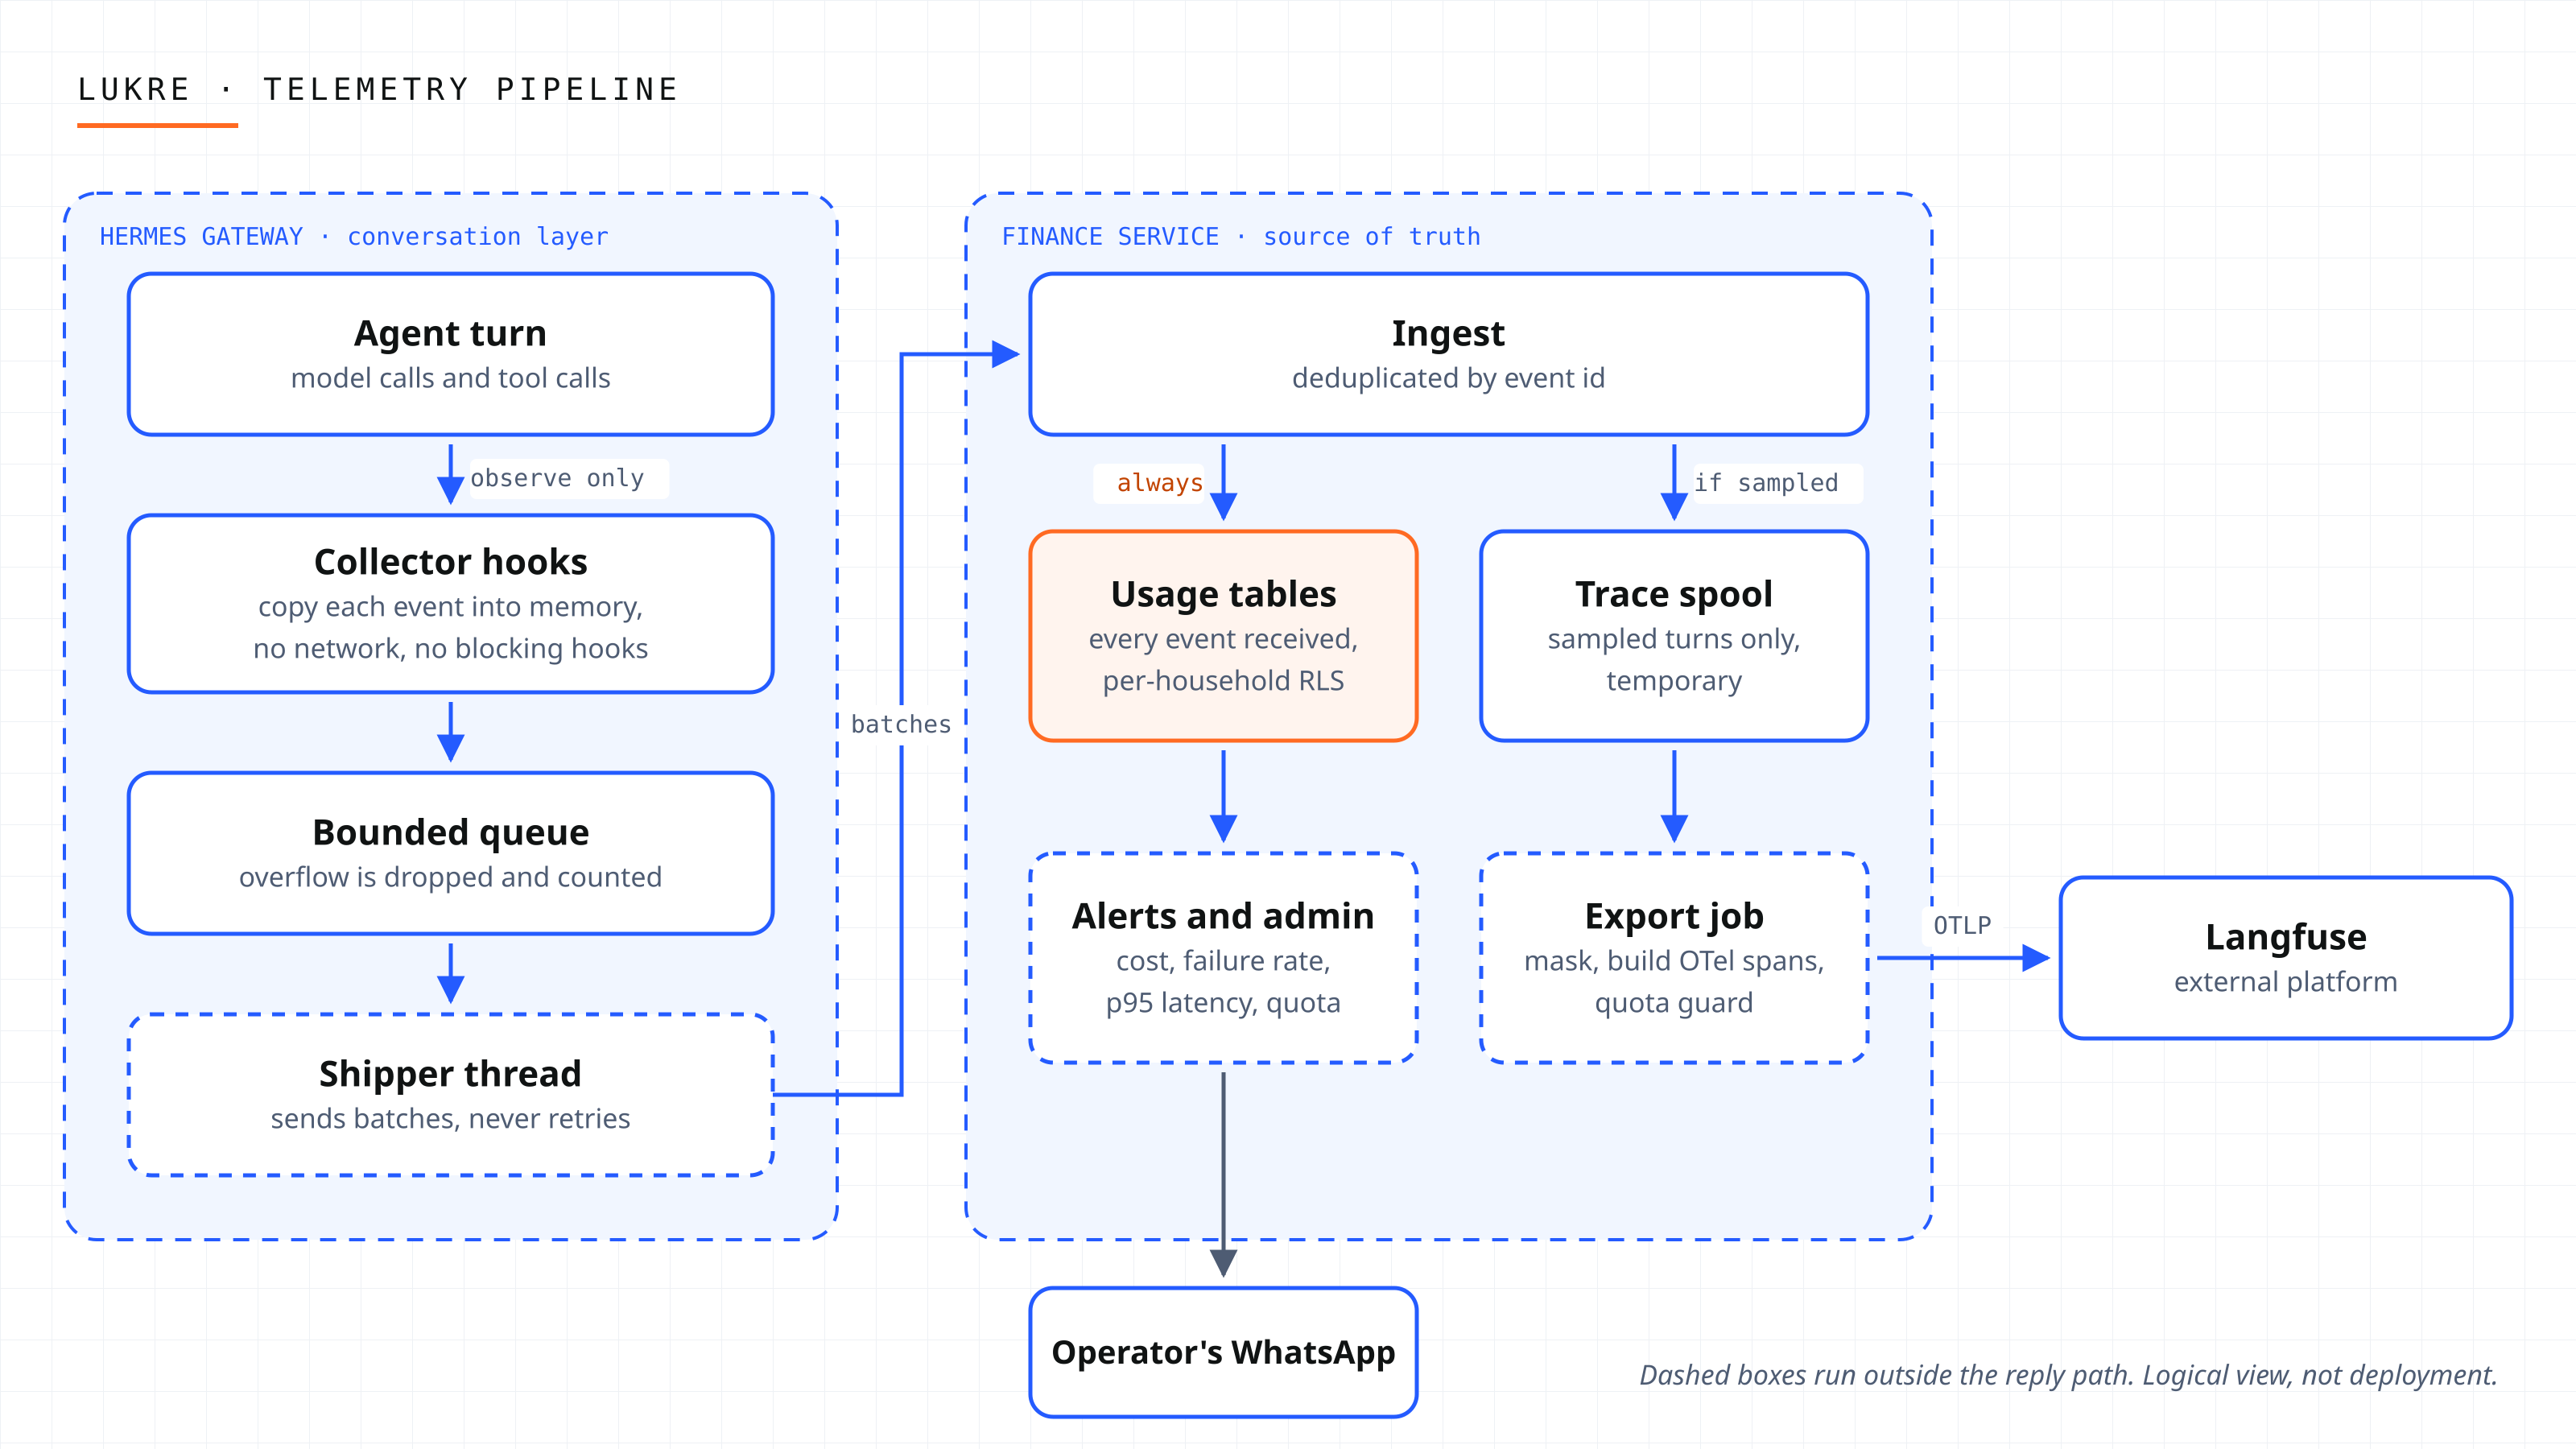
Duas propriedades orientaram todo o projeto.
Nenhuma resposta espera por uma rede externa. Os hooks do Hermes só montam um pequeno dicionário e o adicionam a uma fila limitada em memória. Uma thread separada envia lotes ao serviço financeiro; a exportação ao Langfuse acontece depois, num job de segundo plano. Até uma falha do coletor é contada e absorvida:
def observe(self, hook, kw):
    try:
        fields = BUILDERS[hook](kw, self.clock())
        self.enqueue(self.event(session, turn, platform, fields))
    except Exception:
        self.callback_failed += 1


def enqueue(self, event):
    if len(self.queue) == self.queue.maxlen:
        self.dropped += 1
    self.queue.append(event)
Trecho reduzido do coletor. Quando a fila enche, o evento mais antigo sai e a perda é contada. Perder telemetria é aceitável. Atrasar uma resposta não. Essa escolha vale para observar o agente, não para dinheiro: os registros financeiros são gravados pelo domínio em transações próprias, sem passar por essa fila.
A amostragem decide o que exportar, não o que contar. Rastros completos custam para armazenar e ler, então só parte dos turnos é exportada. Custo funciona diferente. Todo evento de uso que chega ao serviço vira uma linha nas tabelas por família, protegidas pela mesma segurança por linha do PostgreSQL, com ou sem amostragem do turno. A decisão é por turno, usando hash; todos os eventos dele recebem a mesma resposta mesmo em lotes diferentes:
def sampled(turn_id: str, rate: Decimal) -> bool:
    """The same answer for every event of a turn: a hash of its id against the rate."""
    digest = hashlib.sha256(turn_id.encode()).digest()
    return Decimal(int.from_bytes(digest[:8], "big")) / _HASH_SPACE < rate
Isso torna as tabelas de custo independentes da amostragem, mas não um registro completo. Eventos podem se perder antes da ingestão: fila cheia, reinício com eventos pendentes ou falha no envio do lote. O remetente nunca repete. Se o envio falha ou excede o tempo, o lote é descartado e contado; do lado do coletor, não se sabe se o serviço já o registrou. Linhas usam identificadores de evento e duplicatas são ignoradas, então o que chega duas vezes conta uma. Na prática, os custos são um limite inferior: completos quando nada foi descartado, e os contadores de perdas informam quando houve descarte.
Escolhendo as ferramentas
Duas escolhas moldaram o restante: a plataforma para armazenar e exibir rastros e o formato para transportá-los.
Langfuse como plataforma. Parti de requisitos, não de uma lista de fornecedores. Precisava de rastros no formato de um turno: chamadas aninhadas de modelos e ferramentas, tokens e custo em cada uma, agrupadas por sessão e usuário. Precisava de datasets, experimentos e notas no mesmo lugar, para unir produção e laboratório e transformar um rastro ruim em caso de teste. Precisava de ingestão OpenTelemetry para não vincular a instrumentação a um SDK de fornecedor. E precisava evitar a saída de dados pessoais, o que significou mascará-los do nosso lado antes de qualquer envio.
O Langfuse cobria tudo isso. O Hermes já tinha integração com ele, embora eu não a usasse em produção, e os dados podem ficar numa região da União Europeia. Phoenix foi a principal alternativa que testei. Também foi feito para rastros e avaliações de LLMs e fala OpenTelemetry, mas não tinha integração no Hermes; hospedar qualquer um exigiria operar uma infraestrutura analítica junto do produto. Preferi não fazer isso.
O custo dessa escolha é que os rastros saem dos sistemas do Lukre. Por isso o mascaramento virou a parte mais importante do projeto e a política de privacidade foi atualizada para informar o Langfuse antes de qualquer envio.
OpenTelemetry como formato. Em produção, a exportação usa OpenTelemetry via OTLP, com atributos das convenções semânticas GenAI. Elas ainda estão em desenvolvimento: fixei a versão 1.37 no código e espero renomeações. O SDK Langfuse só aparece no laboratório, onde datasets e notas são seu ponto forte.
attributes.update({
    "gen_ai.operation.name": "chat",
    "gen_ai.request.model": model,
    "gen_ai.usage.input_tokens": tokens["input"],
    "langfuse.observation.type": "generation",
    "langfuse.observation.usage_details": json.dumps(usage),
})
As chaves gen_ai.* são do OpenTelemetry. As langfuse.* são campos do Langfuse que fazem um span aparecer como geração com uso de tokens na interface. Cada turno vira um span raiz, com um filho por chamada de modelo e ferramenta, temporizados pelos eventos, não pela exportação. Mudar de backend não seria grátis: a camada langfuse.* precisaria ser reescrita. Mas os spans, sua estrutura e os atributos gen_ai.* seriam preservados.
Mascarar antes de exportar
Depurar um agente exige ver o que cada chamada de modelo e ferramenta recebeu e devolveu. Metadados sozinhos não explicam uma escolha errada. Os spans carregam esse conteúdo, com identificadores mascarados, e nunca anexos.
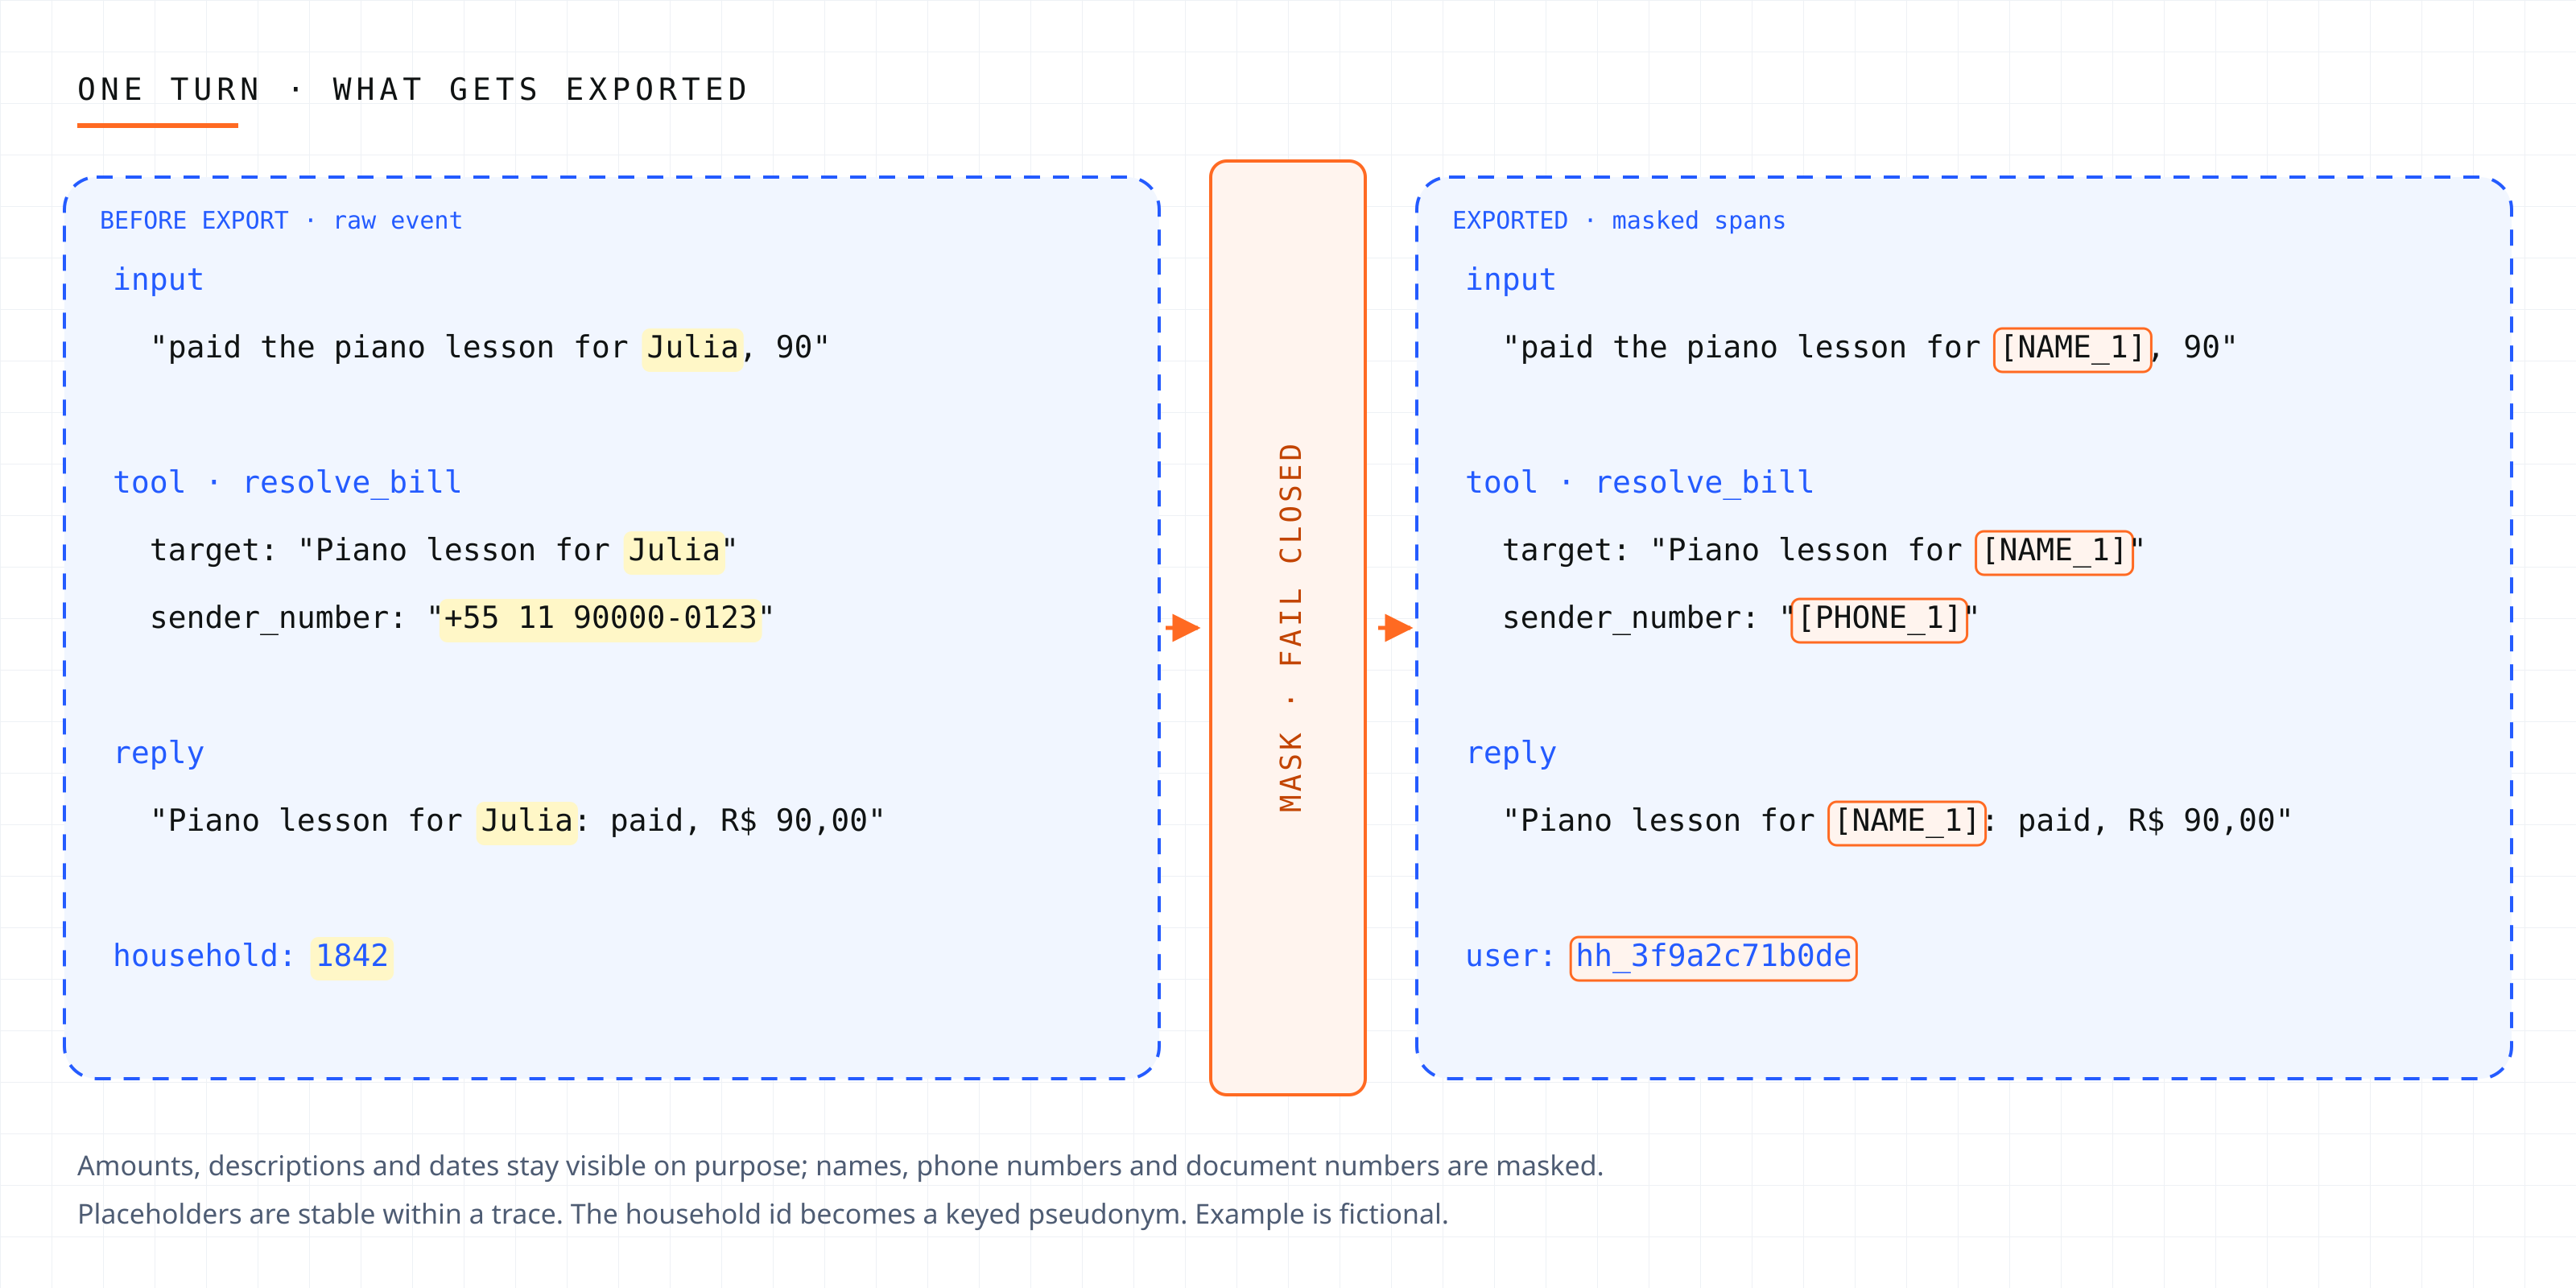
Não há modelo de aprendizado de máquina por trás da máscara. Reconhecimento de entidades acrescentaria uma dependência pesada, com falhas difíceis de reproduzir em testes. A máscara é determinística e aplica três camadas em ordem:
- nomes e telefones dos próprios membros da família, lidos do banco;
- padrões validados: documentos fiscais brasileiros com dígitos verificadores, cartões com verificação Luhn, e-mails, CEPs, endereços e telefones;
- uma lista de cerca de 3.000 nomes comuns e 1.000 sobrenomes.
Marcadores são estáveis dentro do rastro: a mesma pessoa é sempre [NAME_1]. O identificador da família vira pseudônimo HMAC, com um segredo que nunca sai do serviço. A máscara falha fechado: qualquer valor não tratável ou exceção vira [REDACTED].
Os erros se escondem nos padrões. Um formato de telefone que deixei passar, com espaço depois do primeiro dígito do celular, apareceu na revisão e agora é um teste. E um preço como “R$ 11999,90” nunca pode parecer um telefone, o que tem seu próprio teste.
É preciso dizer claramente o que isso é e o que não é. O mascaramento remove identificadores diretos. Não é anonimização. Valores, descrições e datas continuam visíveis de propósito, pois são necessários para depurar um agente financeiro; combinados de determinada forma, ainda podem revelar algo sobre uma família. Nomes ausentes dos dados dos membros e da lista podem passar. O pseudônimo protege o identificador da família de quem não tem a chave, nada mais.
Depois da implantação, conferi o que chegou ao Langfuse. Nas 18 observações exportadas que inspecionei, a busca por telefones, nomes e sobrenomes não encontrou nenhum; encontrou 20 marcadores no lugar deles. É evidência de que a máscara funcionou nesses turnos, não prova de que nunca falha.
Amostragem dentro do orçamento
O Langfuse mede uso em unidades, e cada turno consome algumas conforme o número de chamadas. A produção tem orçamento mensal; contamos o uso do nosso lado porque consultá-lo no Langfuse tem limite de requisições.
Abaixo de uma fração de proteção do orçamento, vale a taxa configurada. Acima, a taxa diminui para que a projeção do restante do mês caiba no orçamento:
def effective_rate(configured, units_month, share, day, days_in_month):
    """Configured below the guard; above it, scale so the month ends within the share."""
    if units_month >= share:
        return Decimal(0)
    if units_month < GUARD_FRACTION * share:
        return configured
    daily = Decimal(units_month) / Decimal(max(day, 1))
    projected = daily * Decimal(max(days_in_month - day + 1, 1))
    guarded = (Decimal(share - units_month) / projected).quantize(_RATE_STEP, ROUND_DOWN)
    return min(configured, guarded)
Uma taxa menor significa apenas menos rastros detalhados. As tabelas de uso não dependem dela.
Na exportação, a semântica de entrega importa: um timeout não significa o que parece. Quando o job desiste de esperar, a requisição pode não ter saído, ter sido processada pelo Langfuse ou ter sido processada com a resposta perdida. O resultado é desconhecido. Por isso, a exportação nunca supõe uma falha limpa. Linhas temporárias só são excluídas após a confirmação do lote; o restante fica e é reenviado depois. Para isso ser seguro, identificadores de rastros e spans são derivados deterministicamente da família e do turno: duas exportações carregam os mesmos identificadores e chegam às mesmas observações, sem criar outro rastro. O cliente HTTP também tem prazo para terminar dentro da espera do job, reduzindo chegadas tardias, embora o projeto não dependa disso. É entrega pelo menos uma vez com identificadores idempotentes, não exatamente uma vez.
Algumas falhas não merecem repetição. Se o Langfuse rejeita um lote por formato ou tamanho, reenviar os mesmos bytes não ajuda. O lote é dividido ao meio e reenviado até isolar o turno recusado. Esse turno é descartado e registrado no log; o restante continua.
Alertas
No Langfuse, exploramos rastros individualmente. Mas perguntas como “quanto custa cada família neste mês?” precisam de um histórico que fique no Lukre. Por isso a administração ganhou uma página de observabilidade própria, que lê as tabelas de uso e mostra custo por família, tempo de resposta, falhas e cota.
Não quero ficar olhando essa página. Um job periódico verifica os números e me envia uma mensagem no WhatsApp quando um limite é ultrapassado:
- o orçamento mensal de rastros se aproxima do limite;
- a proporção de turnos com falha passa do limiar, após haver turnos suficientes para que uma falha não pareça tendência;
- as respostas mais lentas demoram mais do que deveriam;
- o custo diário ultrapassa o limite, ou uma família custa várias vezes mais que a típica.
As mensagens usam a mesma fila dos lembretes, no máximo uma por tipo de alerta por dia, para uma tarde ruim não virar cinquenta notificações. Os limites são ajustáveis na administração.
O que os rastros mostraram sobre custo
Essa parte confirmou o que eu esperava, com números.

Uma chamada de produção com cache aquecido, detalhada. Custos estimados pela contagem de tokens e pelos preços por token do modelo.
Cada ida ao modelo reenvia todo o contexto: instruções, persona, definições de ferramentas e histórico da sessão. Na chamada detalhada, foram 168.464 tokens de entrada, dos quais 167.936 vieram do cache de prompts do provedor. Só 528 eram novos. Num agente com ferramentas, era aí que o custo estaria. A boa notícia: o cache já fazia seu trabalho. Tokens em cache custam um décimo do preço normal de entrada, mantendo a chamada em cerca de US$ 0,0045 mesmo com 93% destinados ao contexto.
Esses 93% descrevem uma chamada, não o sistema. Outras chamadas com cache tinham entre cerca de 167.000 e 183.000 tokens de contexto, e as do mesmo turno custavam a poucos décimos de centavo dela, sugerindo o mesmo padrão. Mas só detalhei esta. O contraste com cache frio é mais claro: a primeira chamada após reiniciar o Hermes, sem cache no provedor, custou US$ 0,042, quase dez vezes mais. É uma observação única, mas condiz com a cobrança.

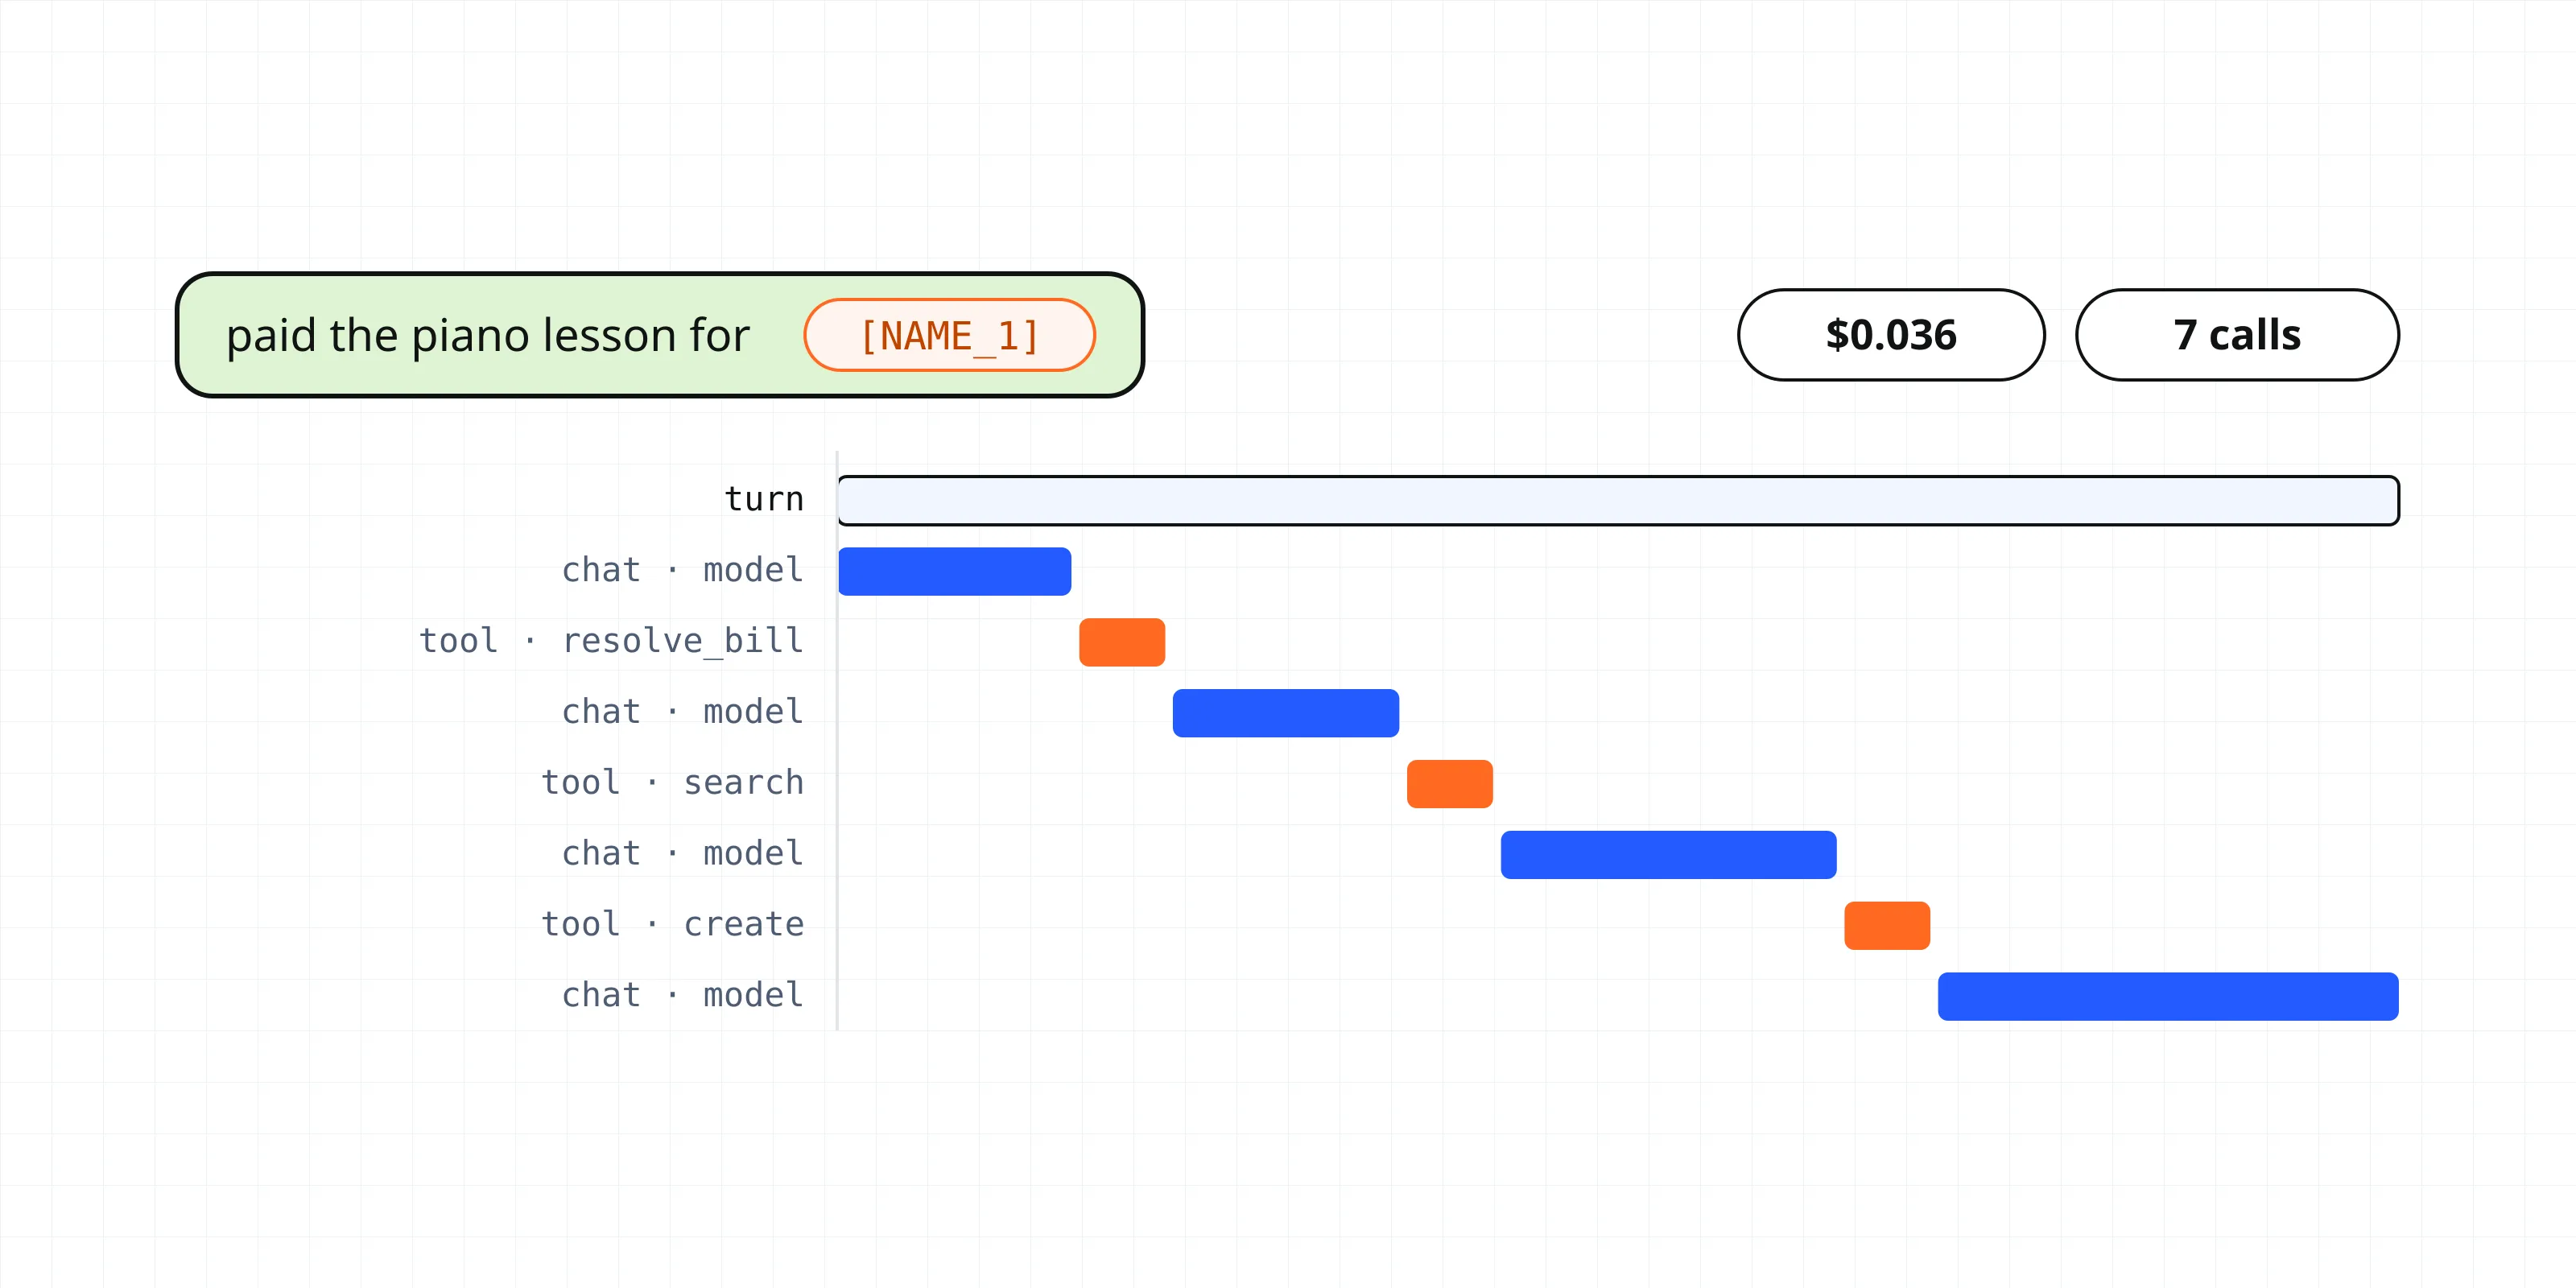
Um turno de produção. Cada resultado de ferramenta exige outra ida ao modelo com todo o contexto.
Um turno movimentado usou seis ferramentas e sete chamadas de modelo, por US$ 0,036. O custo acompanha o número de idas ao modelo, não o tamanho da mensagem. A chamada após list_recurring recebeu cerca de 11.000 tokens novos de saída da ferramenta e custou 60% mais que as vizinhas.
A economia, quando vier, estará na engenharia de contexto, não em prompts menores para o usuário: contexto fixo menor, menos idas ao modelo por mensagem e ferramentas com resultados mais enxutos. Nada disso está feito ainda. Agora, ao menos, poderei medir quando estiver.
O laboratório de avaliação
A segunda metade do trabalho foi um laboratório para responder à pergunta do artigo anterior: uma mudança melhora ou piora o agente?
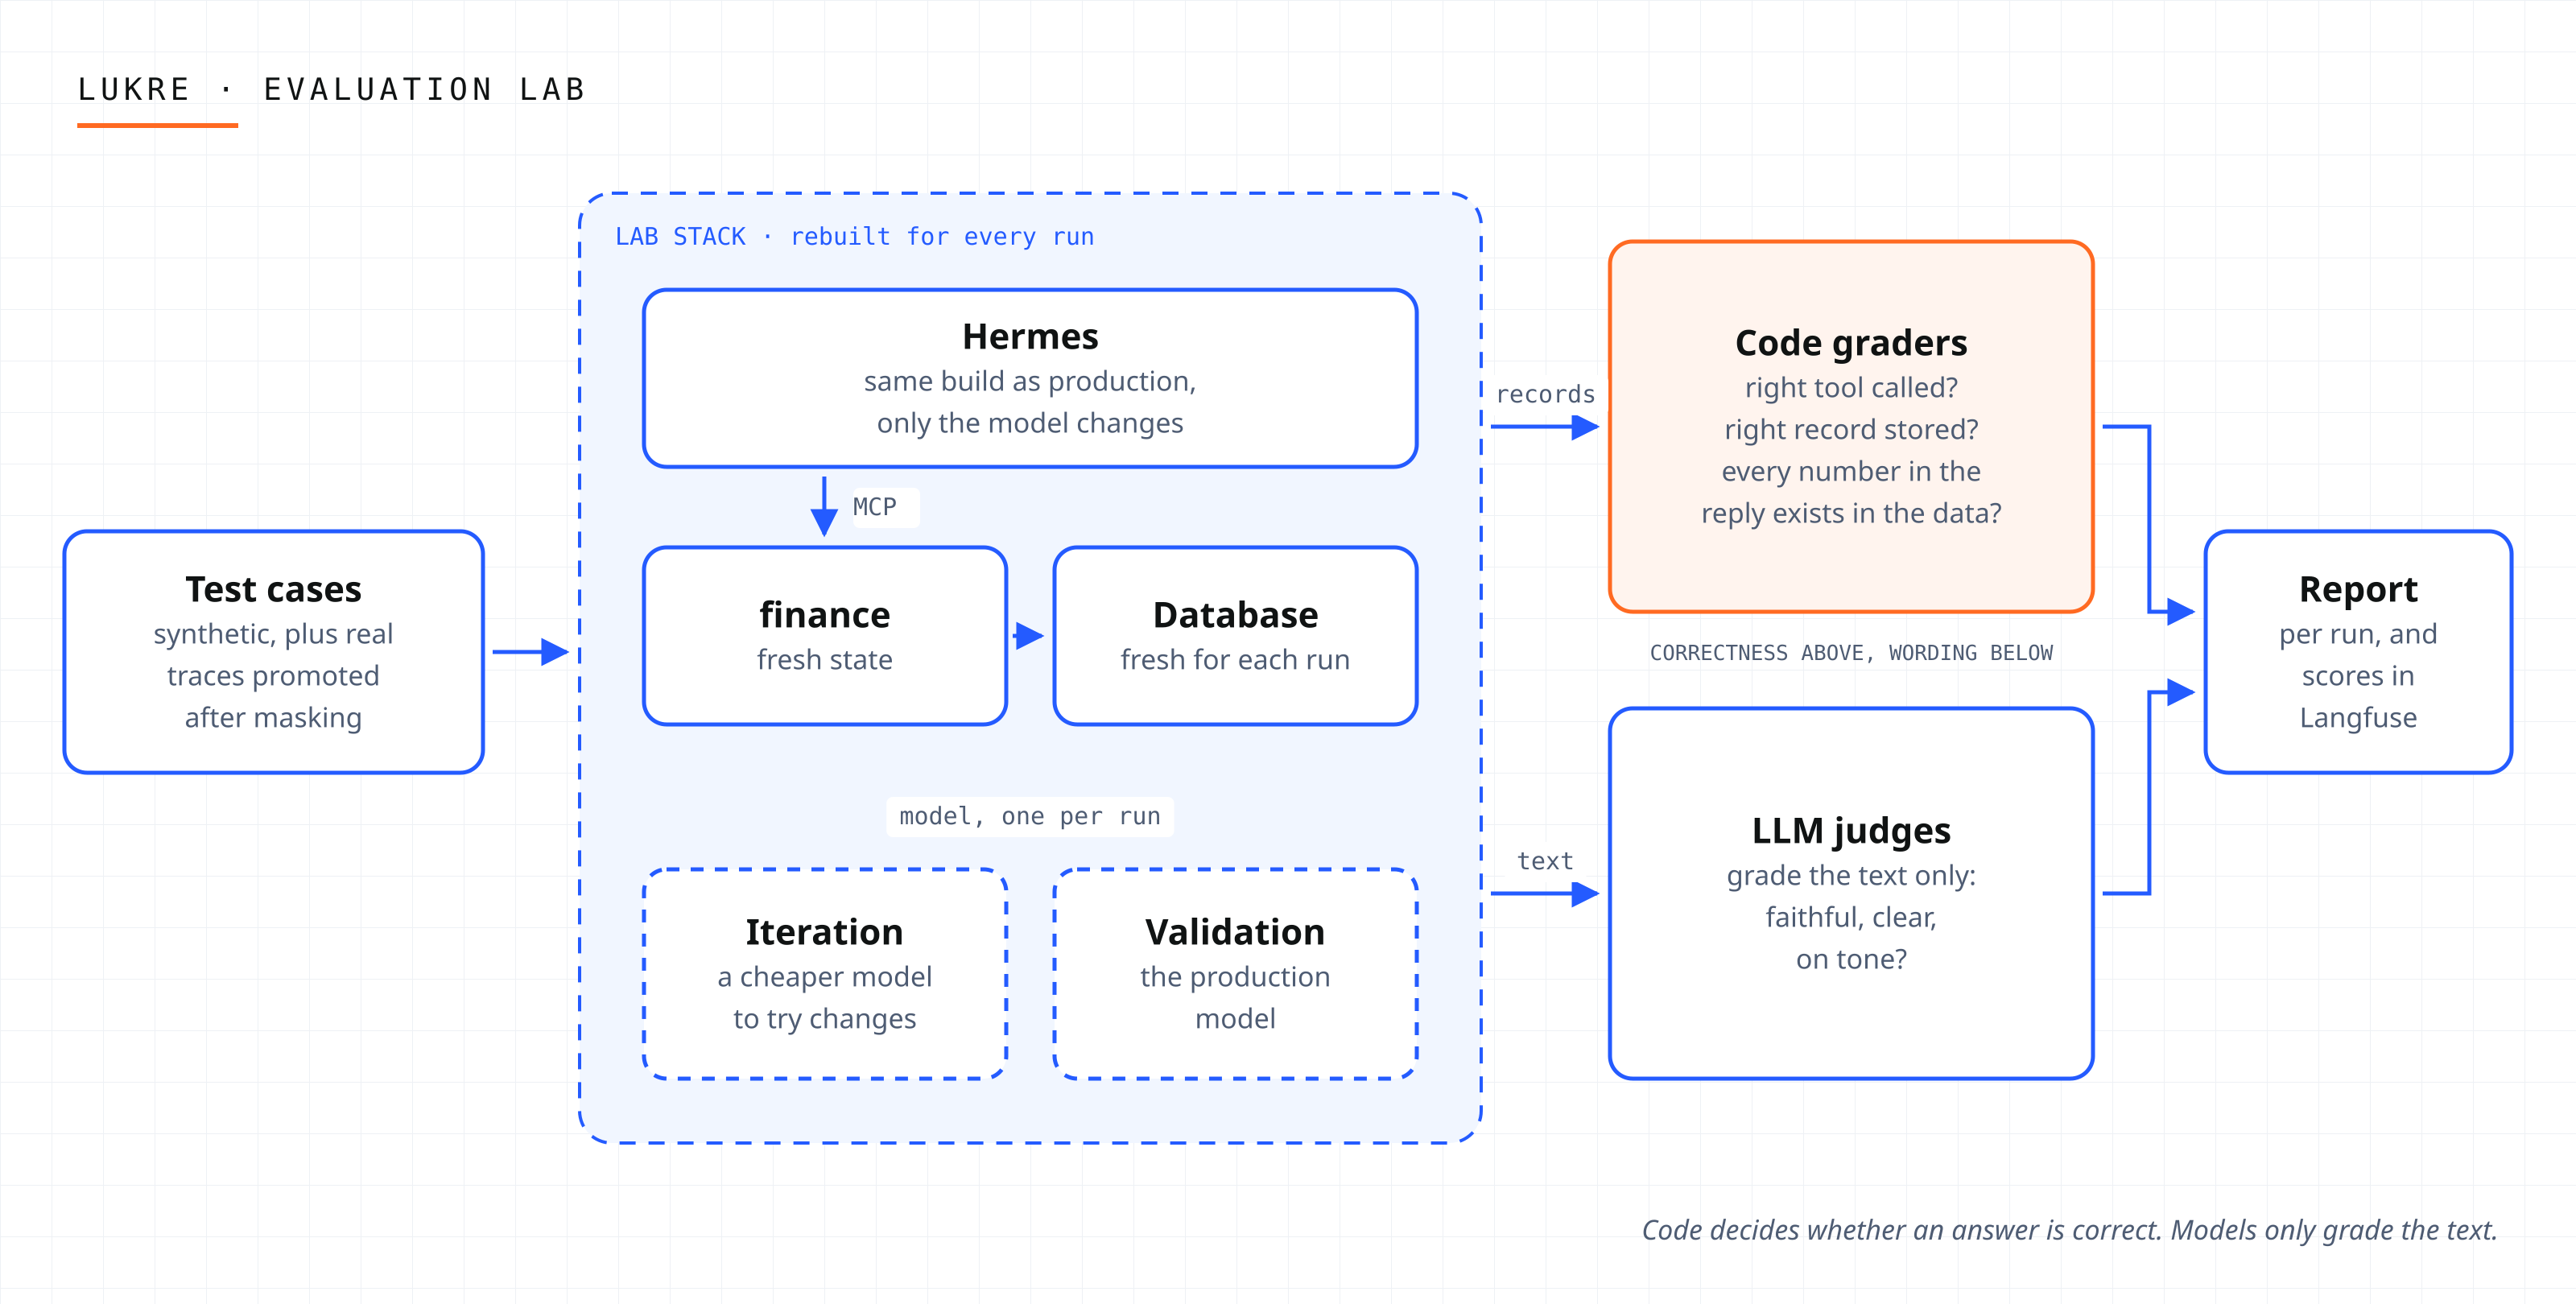
Duas decisões o definem:
- O mesmo agente da produção. O laboratório usa a versão de produção do Hermes com o template de perfil de produção e banco novo em cada execução. Só muda o modelo. Um laboratório com outro agente mede outro agente.
- Código decide, modelos opinam. Se a ferramenta correta foi chamada, se o registro tem valor, tipo e categoria certos e se todos os números da resposta existem nos dados são verificações de código, lendo o banco após o turno. Juízes LLM só avaliam o texto: fidelidade, clareza e tom.
Conversas reais também podem virar casos. Um comando transforma um rastro de produção, já mascarado, em caso de teste, que fica fora das execuções até alguém escrever o resultado esperado.
A primeira validação usou cinco casos sintéticos de captura e o modelo de produção. Os cinco registros ficaram corretos e a execução custou US$ 0,024. Cinco casos sintéticos são um teste básico, não uma medida de precisão: mostram que laboratório, avaliadores e relatórios funcionam de ponta a ponta nesses casos. Ainda não dizem quão bom é o agente diante do que famílias reais enviam. Isso exige mais casos e jornadas.
Como o trabalho foi feito
O processo merece algumas linhas, porque faz parte de como trabalho hoje.
Tudo começou com uma investigação de viabilidade: ler os hooks do Hermes, testar o plugin incluído e experimentar Phoenix. Depois vieram documento de requisitos com histórias de usuário, especificação técnica e 14 registros de decisões arquiteturais, cada um com contexto, alternativas e consequências. A especificação incluía um contrato dos testes a escrever antes de existir código.
A implementação foi dividida em oito tarefas com grafo de dependências e executada por agentes em paralelo, em três ondas. A revisão apontou 20 problemas: um crítico, cinco altos, dez médios e quatro baixos; todos foram corrigidos. Vários detalhes deste artigo, do padrão de telefone à divisão dos lotes rejeitados, vieram dessa revisão. As suítes unitárias e do plugin agora somam mais de 2.900 testes.
Os números e seus limites
Os custos vêm de poucos turnos de produção no dia da implantação e são estimativas por contagem de tokens e preços unitários. Os tempos de resposta ficaram entre 6,2 e 6,5 segundos por turno nessa pequena amostra. Os números do laboratório vêm de cinco casos sintéticos, revisados por um modelo de IA, não por mim. Mostram que os instrumentos funcionam. Não são um benchmark; prefiro dizer aqui a deixar o leitor descobrir.
O que vem depois
Uma mudança está na minha lista. Hoje, a passagem do agente ao serviço financeiro usa uma fila em memória esvaziada por uma thread. Nunca atrasa respostas, mas perde eventos pendentes no reinício e lotes cujo envio falha. Ambos são contados, não recuperados. Um broker entre os dois tornaria a passagem durável e permitiria múltiplos consumidores dos mesmos eventos. Também seria mais um serviço para operar e observar, então precisa justificar seu lugar. Essa é a próxima decisão e, como as outras, terá seu próprio ADR.
Seguindo o dinheiro
O Lukre existe para responder a uma pergunta da família: para onde foi o dinheiro? Supermercado, conta de luz, aplicativo de delivery que ninguém admite usar.
A observabilidade fez a mesma pergunta ao próprio Lukre, e a resposta parecia um extrato doméstico: uma linha muito maior que as outras. Numa família, muitas vezes é o delivery. No Lukre, na chamada que detalhei, eram 167.936 tokens de contexto em cache, reenviados em cada ida ao modelo e responsáveis por 93% da conta.
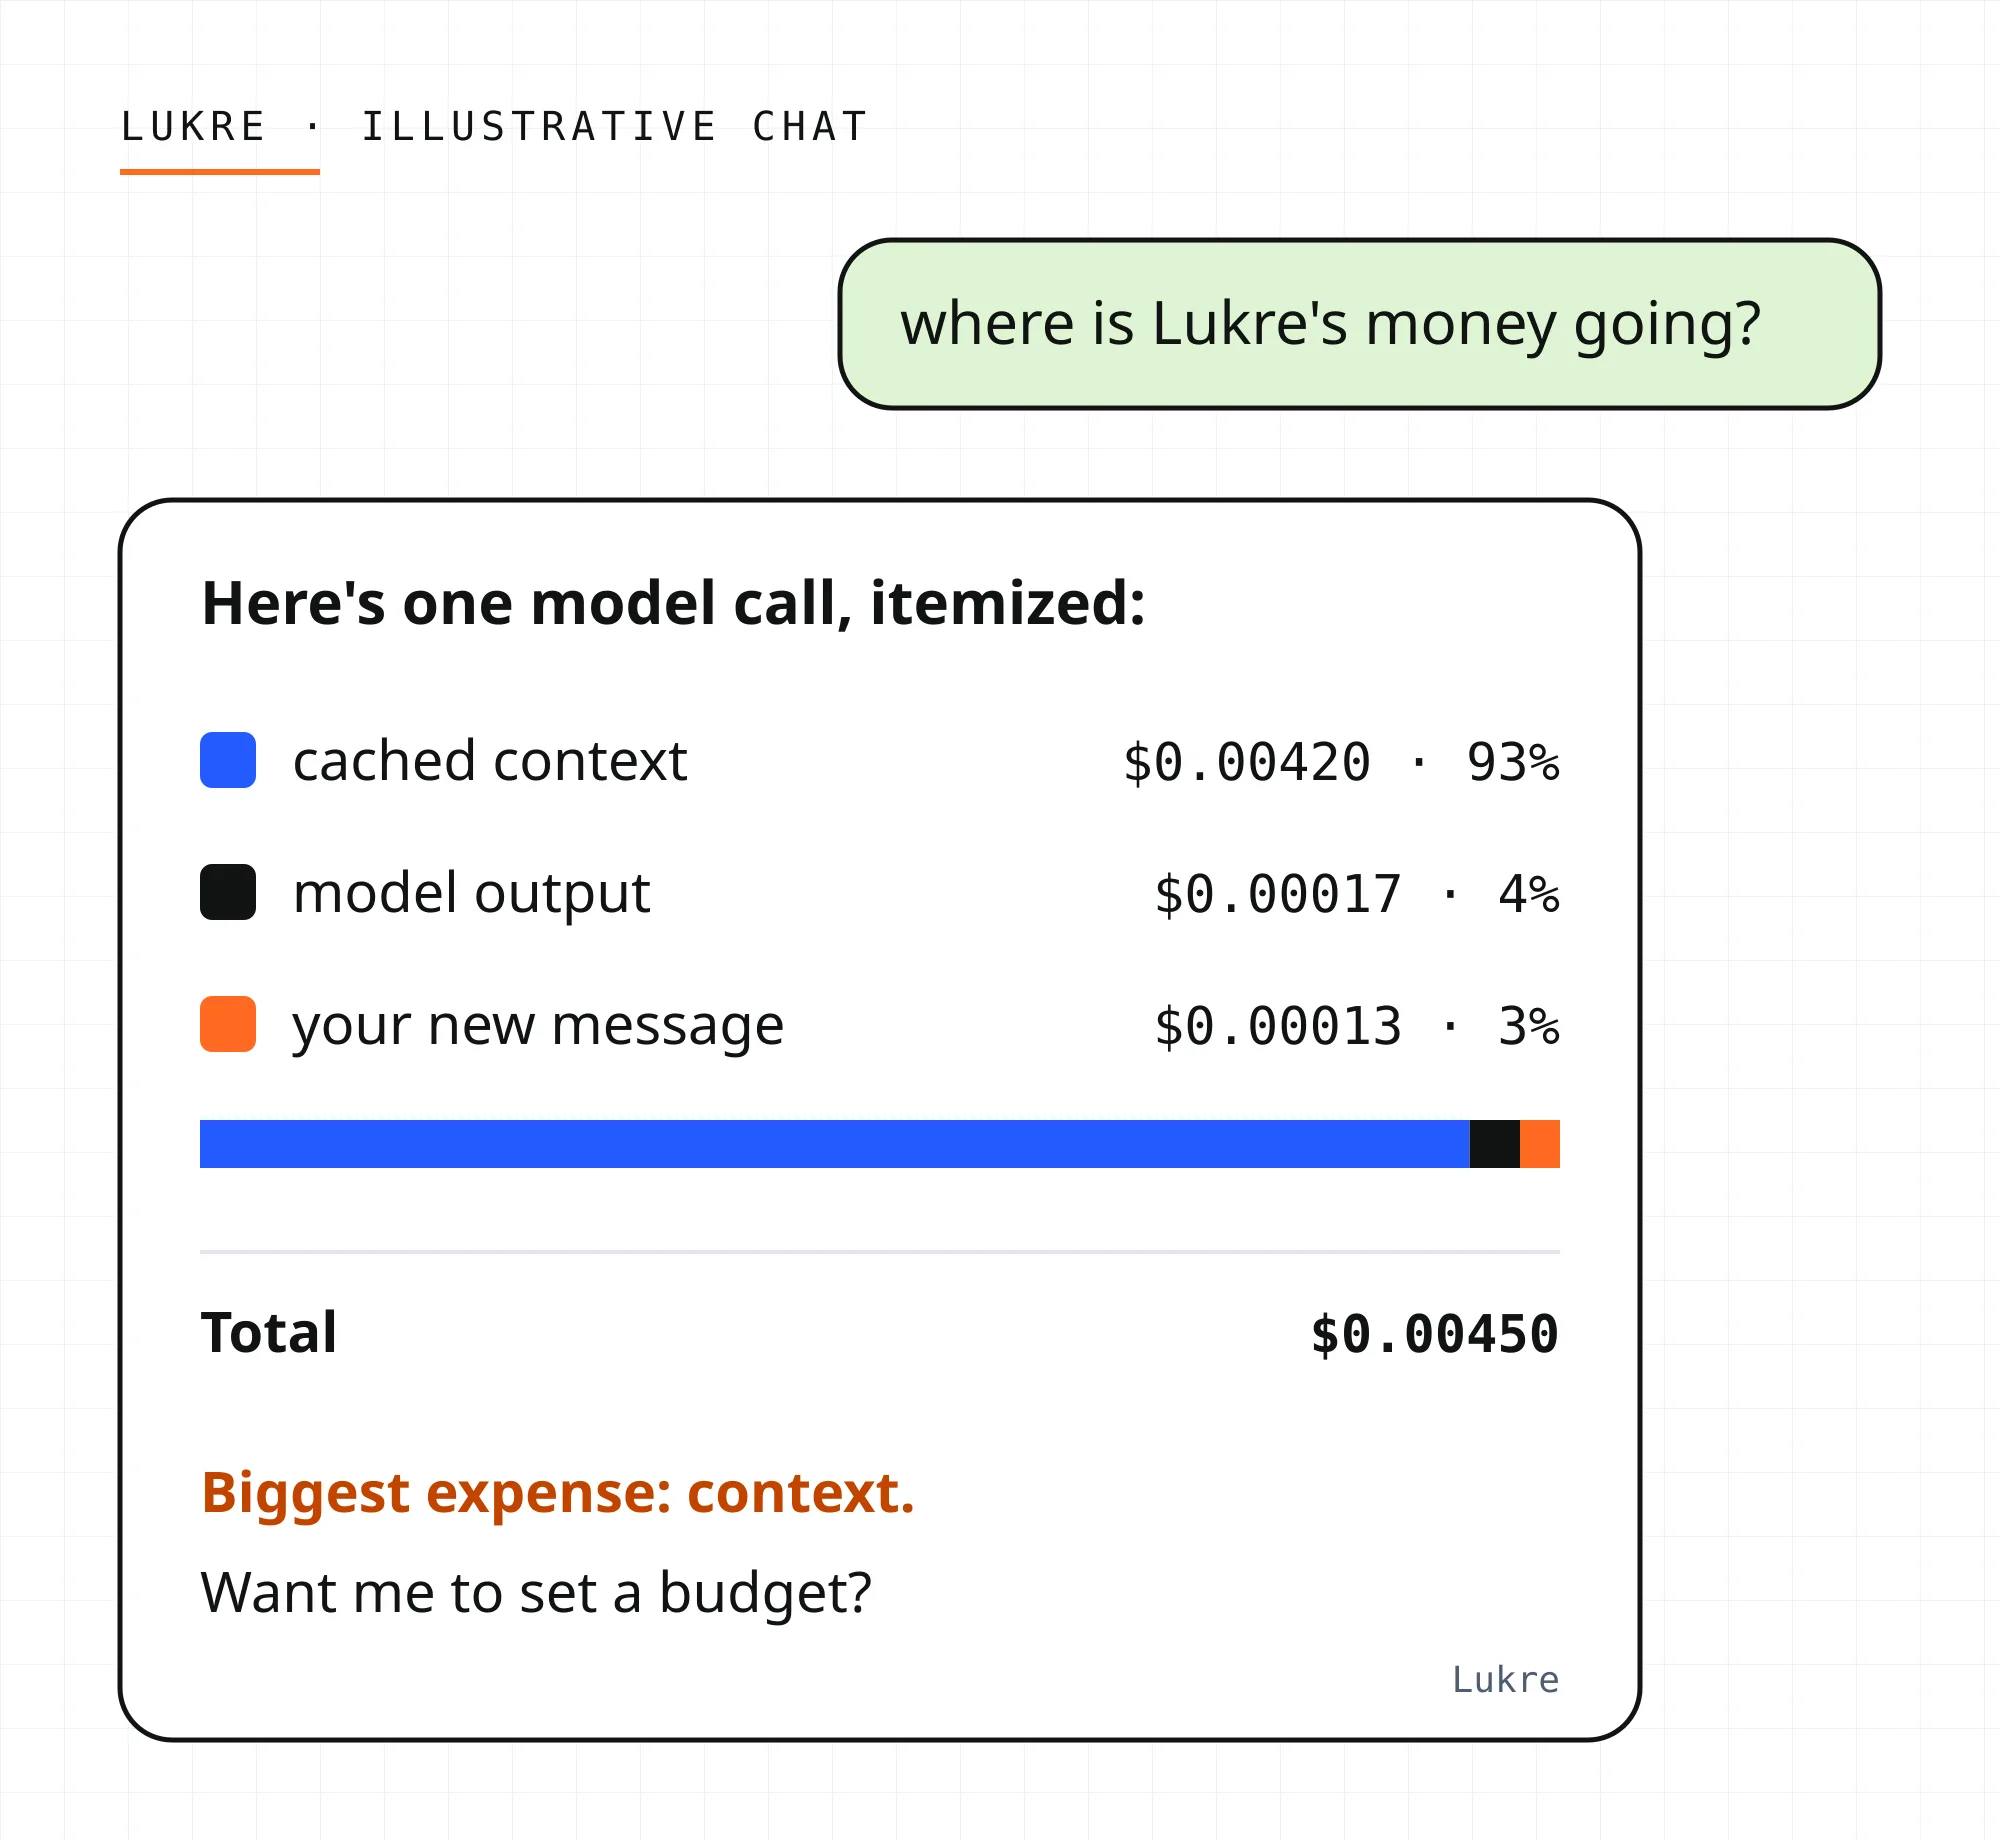
Conversa ilustrativa. O detalhamento é o custo estimado de uma chamada de produção.
Agora o Lukre tem seu próprio extrato. O próximo passo é o que toda família conhece: cortar o gasto que estava bem à vista.
Você pode conhecer o Lukre e o que ele faz ou ler sobre sua construção em Construindo o Lukre.