Observando trabajar a un agente: observabilidad y evaluaciones en Lukre
Cómo añadí observabilidad de LLM y un laboratorio de evaluación a Lukre: trazas, privacidad, costes de modelos y los límites de los primeros resultados.
Al final de Construyendo Lukre, escribí que el siguiente paso real era medir. La aplicación tenía pruebas. El modelo tenía instrucciones y comprobaciones. Y yo solo podía esperar que cambiar un prompt o modelo mejorase las cosas.
Esta es la continuación. Añadí observabilidad y un laboratorio de evaluación a Lukre, el asistente de finanzas domésticas de WhatsApp que funciona en producción con hogares reales.
Quería responder a cinco preguntas: ¿es correcto, qué precisión tiene, cuánto espera el miembro, cuánto cuesta y qué falla? Una regla venía antes que todas: la producción no puede empeorar. Ninguna respuesta puede esperar a un proveedor de observabilidad.
Esto es lo que construí, las decisiones que hay detrás y lo que mostraron los números, dentro de sus límites.
El plugin incluido
Hermes, el entorno de agentes detrás de Lukre, incluye un plugin de Langfuse. Activarlo habría requerido una línea de configuración.
Pero antes de poner nada en el recorrido de una respuesta, leí su código en la versión exacta que fijamos. Había tres problemas:
- Bloquea la respuesta. Al final de cada turno envía los datos a Langfuse de forma síncrona. Si está lento, el agente espera hasta el timeout predeterminado de 30 segundos de los hooks de Hermes.
- Puede bloquear herramientas. Registra un hook antes de cada llamada a herramienta que, en Hermes, falla de forma cerrada: si se cuelga, bloquea la herramienta.
- No enmascara nada. El modo «sanitizado» elimina secretos, no datos personales, y la tasa de muestreo se lee solo al iniciar.
Nada de eso es un defecto en una demostración. En una conversación de WhatsApp con personas reales, los tres lo son. Escribí mi propio recolector con una regla sencilla: la telemetría observa, nunca participa.
Un pipeline fuera del recorrido de la respuesta
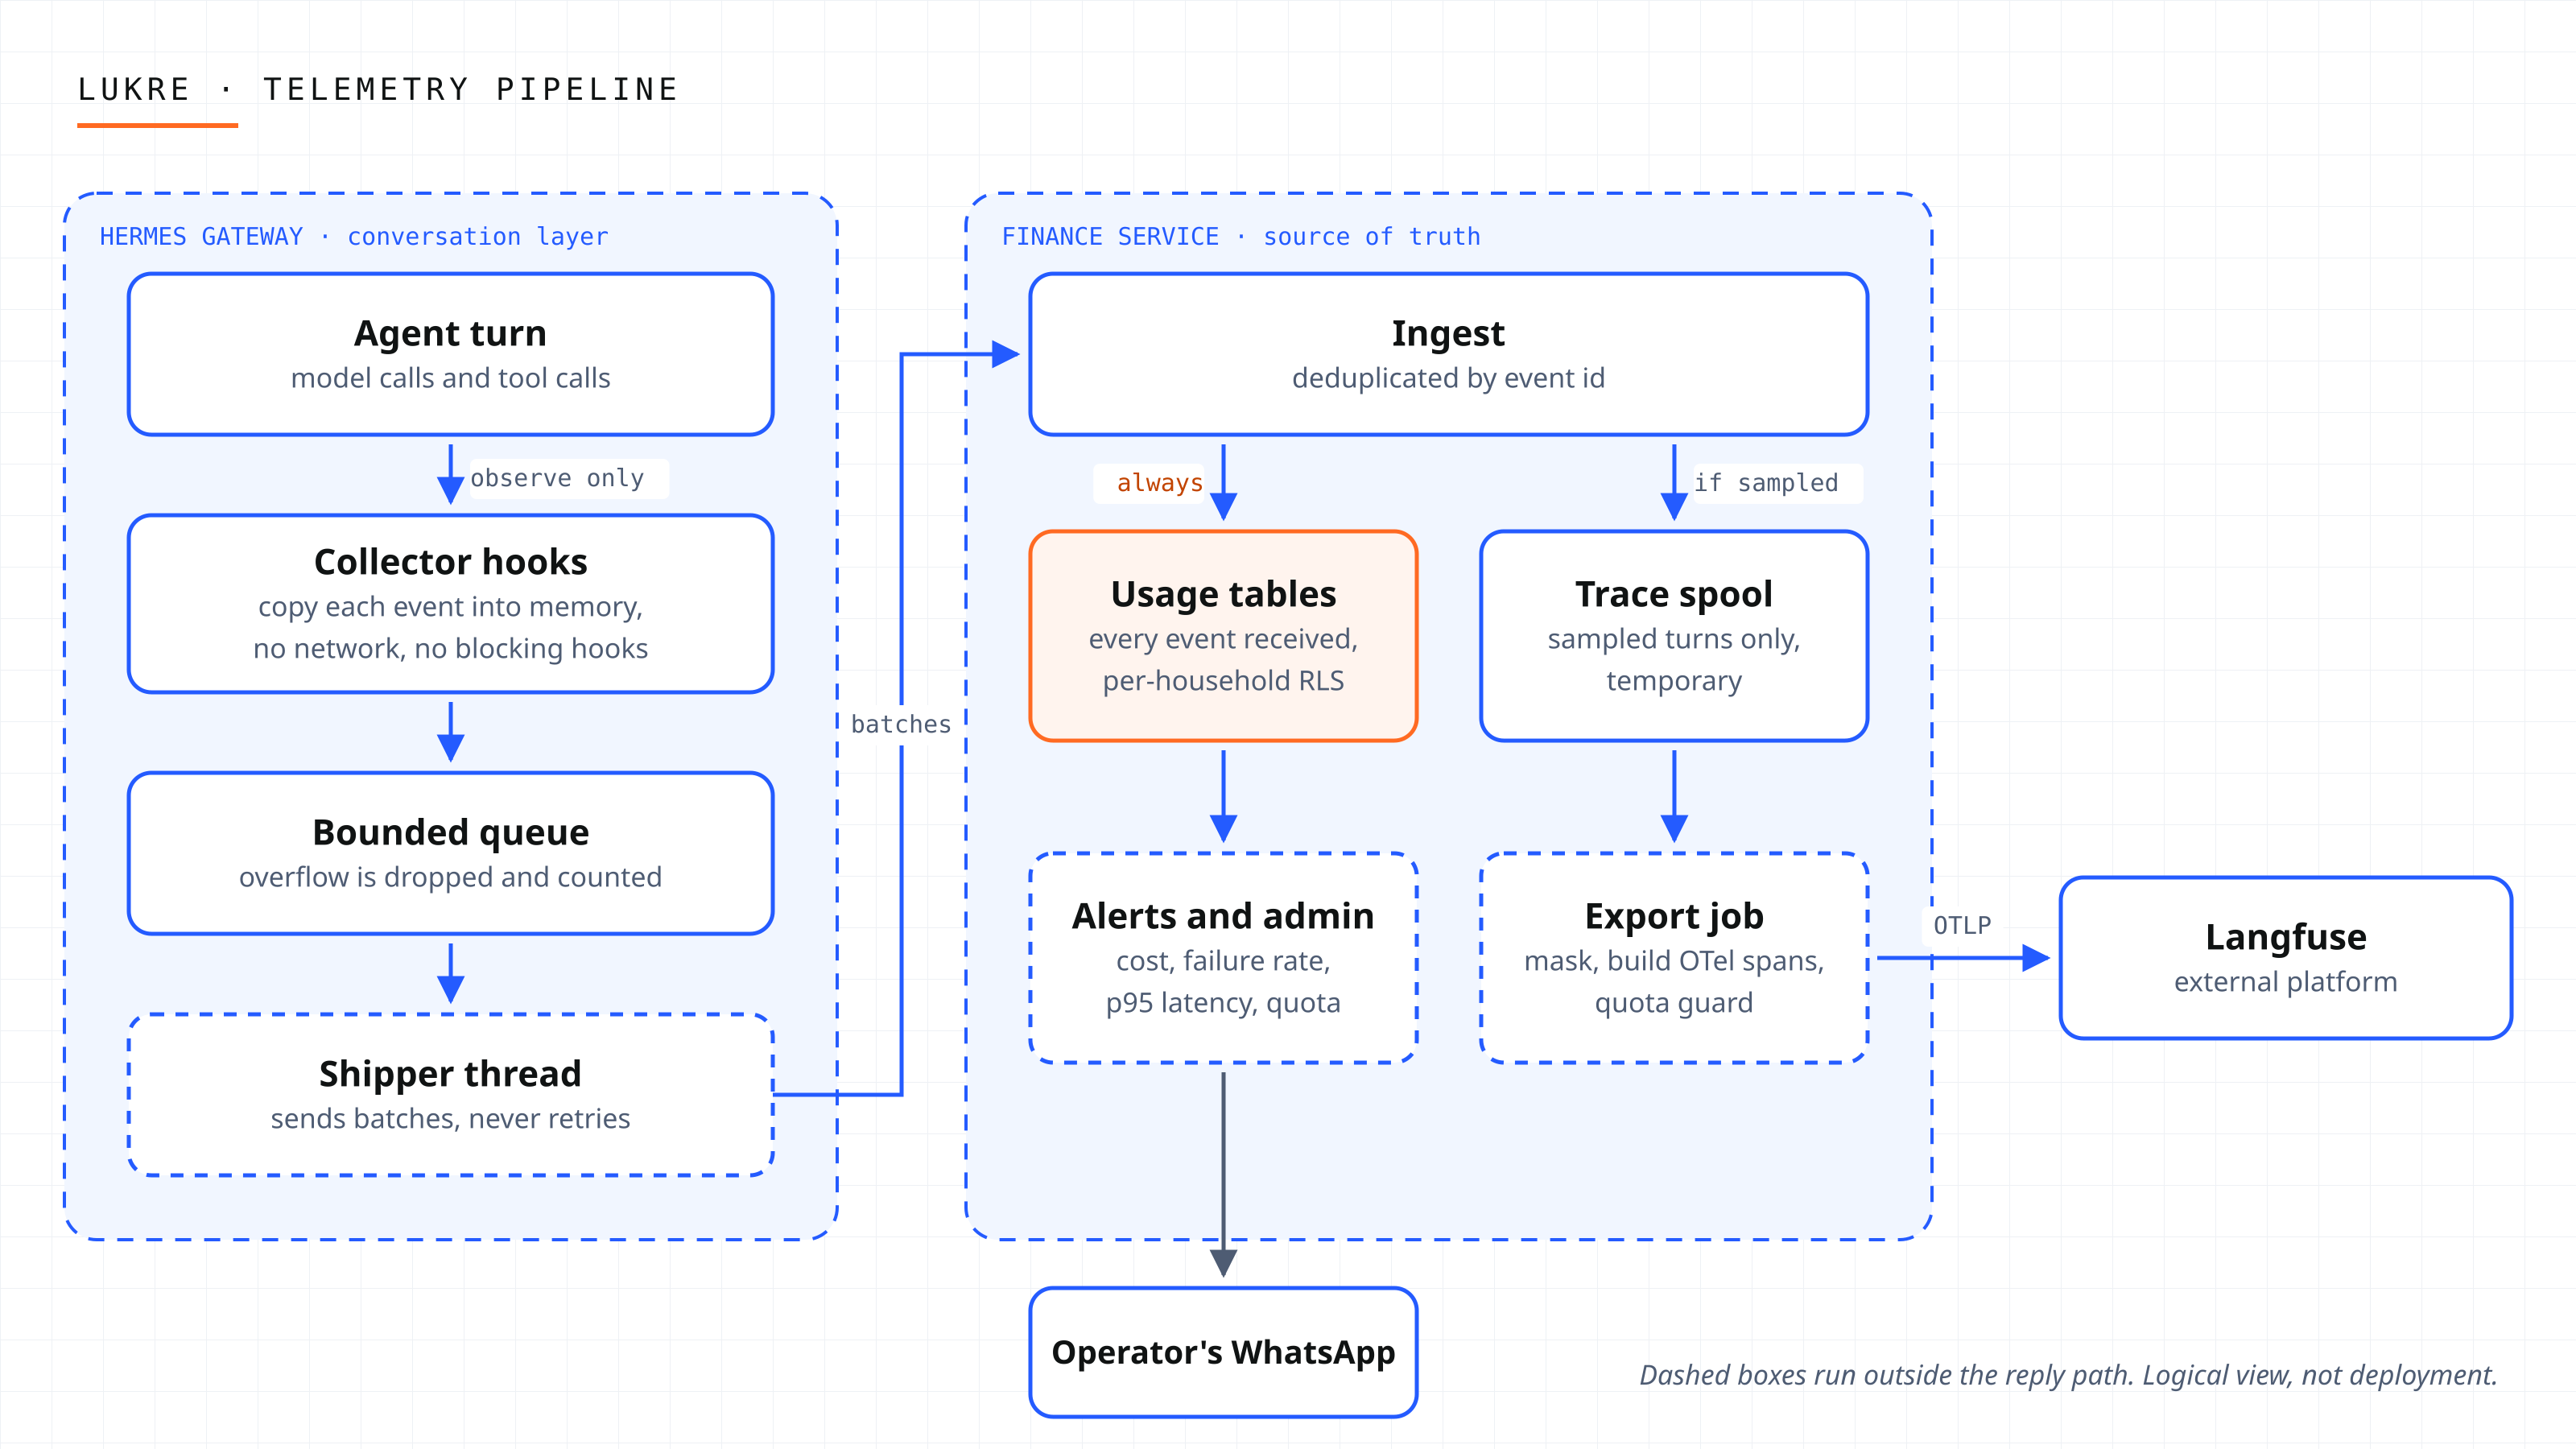
Dos propiedades guiaron todo el diseño.
Ninguna respuesta espera a una red externa. Los hooks de Hermes solo construyen un pequeño diccionario y lo añaden a una cola limitada en memoria. Un hilo separado envía lotes al servicio financiero; la exportación a Langfuse ocurre después, en un job de segundo plano. Incluso un fallo del recolector se cuenta y se absorbe:
def observe(self, hook, kw):
    try:
        fields = BUILDERS[hook](kw, self.clock())
        self.enqueue(self.event(session, turn, platform, fields))
    except Exception:
        self.callback_failed += 1


def enqueue(self, event):
    if len(self.queue) == self.queue.maxlen:
        self.dropped += 1
    self.queue.append(event)
Fragmento reducido del recolector. Cuando la cola se llena, se elimina el evento más antiguo y se cuenta la pérdida. Perder telemetría es aceptable. Retrasar una respuesta no. Esa decisión se refiere a observar al agente, no al dinero: el dominio guarda los registros financieros en sus propias transacciones, sin pasar por esta cola.
El muestreo decide qué exportar, no qué contar. Las trazas completas cuestan almacenarlas y leerlas, por lo que solo se exporta parte de los turnos. El coste funciona de otra manera. Cada evento de uso que llega al servicio se convierte en una fila de las tablas por hogar, protegidas por la misma seguridad por fila de PostgreSQL, se muestree o no el turno. La decisión se toma por turno mediante hash; todos sus eventos reciben la misma respuesta incluso en lotes distintos:
def sampled(turn_id: str, rate: Decimal) -> bool:
    """The same answer for every event of a turn: a hash of its id against the rate."""
    digest = hashlib.sha256(turn_id.encode()).digest()
    return Decimal(int.from_bytes(digest[:8], "big")) / _HASH_SPACE < rate
Esto hace las tablas de coste independientes del muestreo, pero no un registro completo. Los eventos pueden perderse antes de la ingestión: cola llena, reinicio con eventos pendientes o fallo de envío del lote. El emisor nunca reintenta. Si el envío falla o agota el tiempo, el lote se descarta y se cuenta; desde el recolector no se sabe si el servicio ya lo registró. Las filas usan identificadores de evento y se ignoran duplicados, así que lo que llega dos veces cuenta una. En la práctica, los costes son un límite inferior: completos cuando no se descartó nada, y los contadores de pérdidas indican cuándo hubo descartes.
Eligiendo las herramientas
Dos elecciones dieron forma al resto: la plataforma para almacenar y mostrar trazas y el formato para transportarlas.
Langfuse como plataforma. Partí de requisitos, no de una lista de proveedores. Necesitaba trazas con forma de turno: llamadas anidadas de modelos y herramientas, tokens y coste en cada una, agrupadas por sesión y usuario. Necesitaba datasets, experimentos y puntuaciones en el mismo lugar para unir producción y laboratorio y convertir una mala traza en caso de prueba. Necesitaba ingestión OpenTelemetry para no vincular la instrumentación a un SDK de proveedor. Y necesitaba evitar la salida de datos personales, lo que significó enmascararlos de nuestro lado antes de enviarlos.
Langfuse cubría todo eso. Hermes ya tenía integración, aunque no la usara en producción, y los datos pueden permanecer en una región de la Unión Europea. Phoenix fue la principal alternativa que probé. También está hecho para trazas y evaluaciones de LLM y habla OpenTelemetry, pero no tenía integración con Hermes; alojar cualquiera exigiría operar una infraestructura analítica junto al producto. Preferí no hacerlo.
El coste de esa elección es que las trazas salen de los sistemas de Lukre. Por eso el enmascaramiento se convirtió en la parte más importante del diseño y se actualizó la política de privacidad para informar sobre Langfuse antes de enviar nada.
OpenTelemetry como formato. En producción se exporta con OpenTelemetry mediante OTLP y atributos de las convenciones semánticas GenAI. Aún están en desarrollo: fijé la versión 1.37 en el código y espero cambios de nombre. El SDK de Langfuse solo aparece en el laboratorio, donde los datasets y las puntuaciones son su fuerte.
attributes.update({
    "gen_ai.operation.name": "chat",
    "gen_ai.request.model": model,
    "gen_ai.usage.input_tokens": tokens["input"],
    "langfuse.observation.type": "generation",
    "langfuse.observation.usage_details": json.dumps(usage),
})
Las claves gen_ai.* son de OpenTelemetry. Las langfuse.* son campos de Langfuse que hacen que un span aparezca como generación con uso de tokens en la interfaz. Cada turno se convierte en un span raíz, con un hijo por llamada de modelo y herramienta, temporizados por los eventos, no por la exportación. Cambiar de backend no sería gratis: habría que reescribir la capa langfuse.*. Pero los spans, su estructura y los atributos gen_ai.* se conservarían.
Enmascarar antes de exportar
Depurar un agente exige ver qué recibió y devolvió cada llamada de modelo y herramienta. Los metadatos solos no explican una elección incorrecta. Los spans llevan ese contenido, con identificadores enmascarados, y nunca adjuntos.
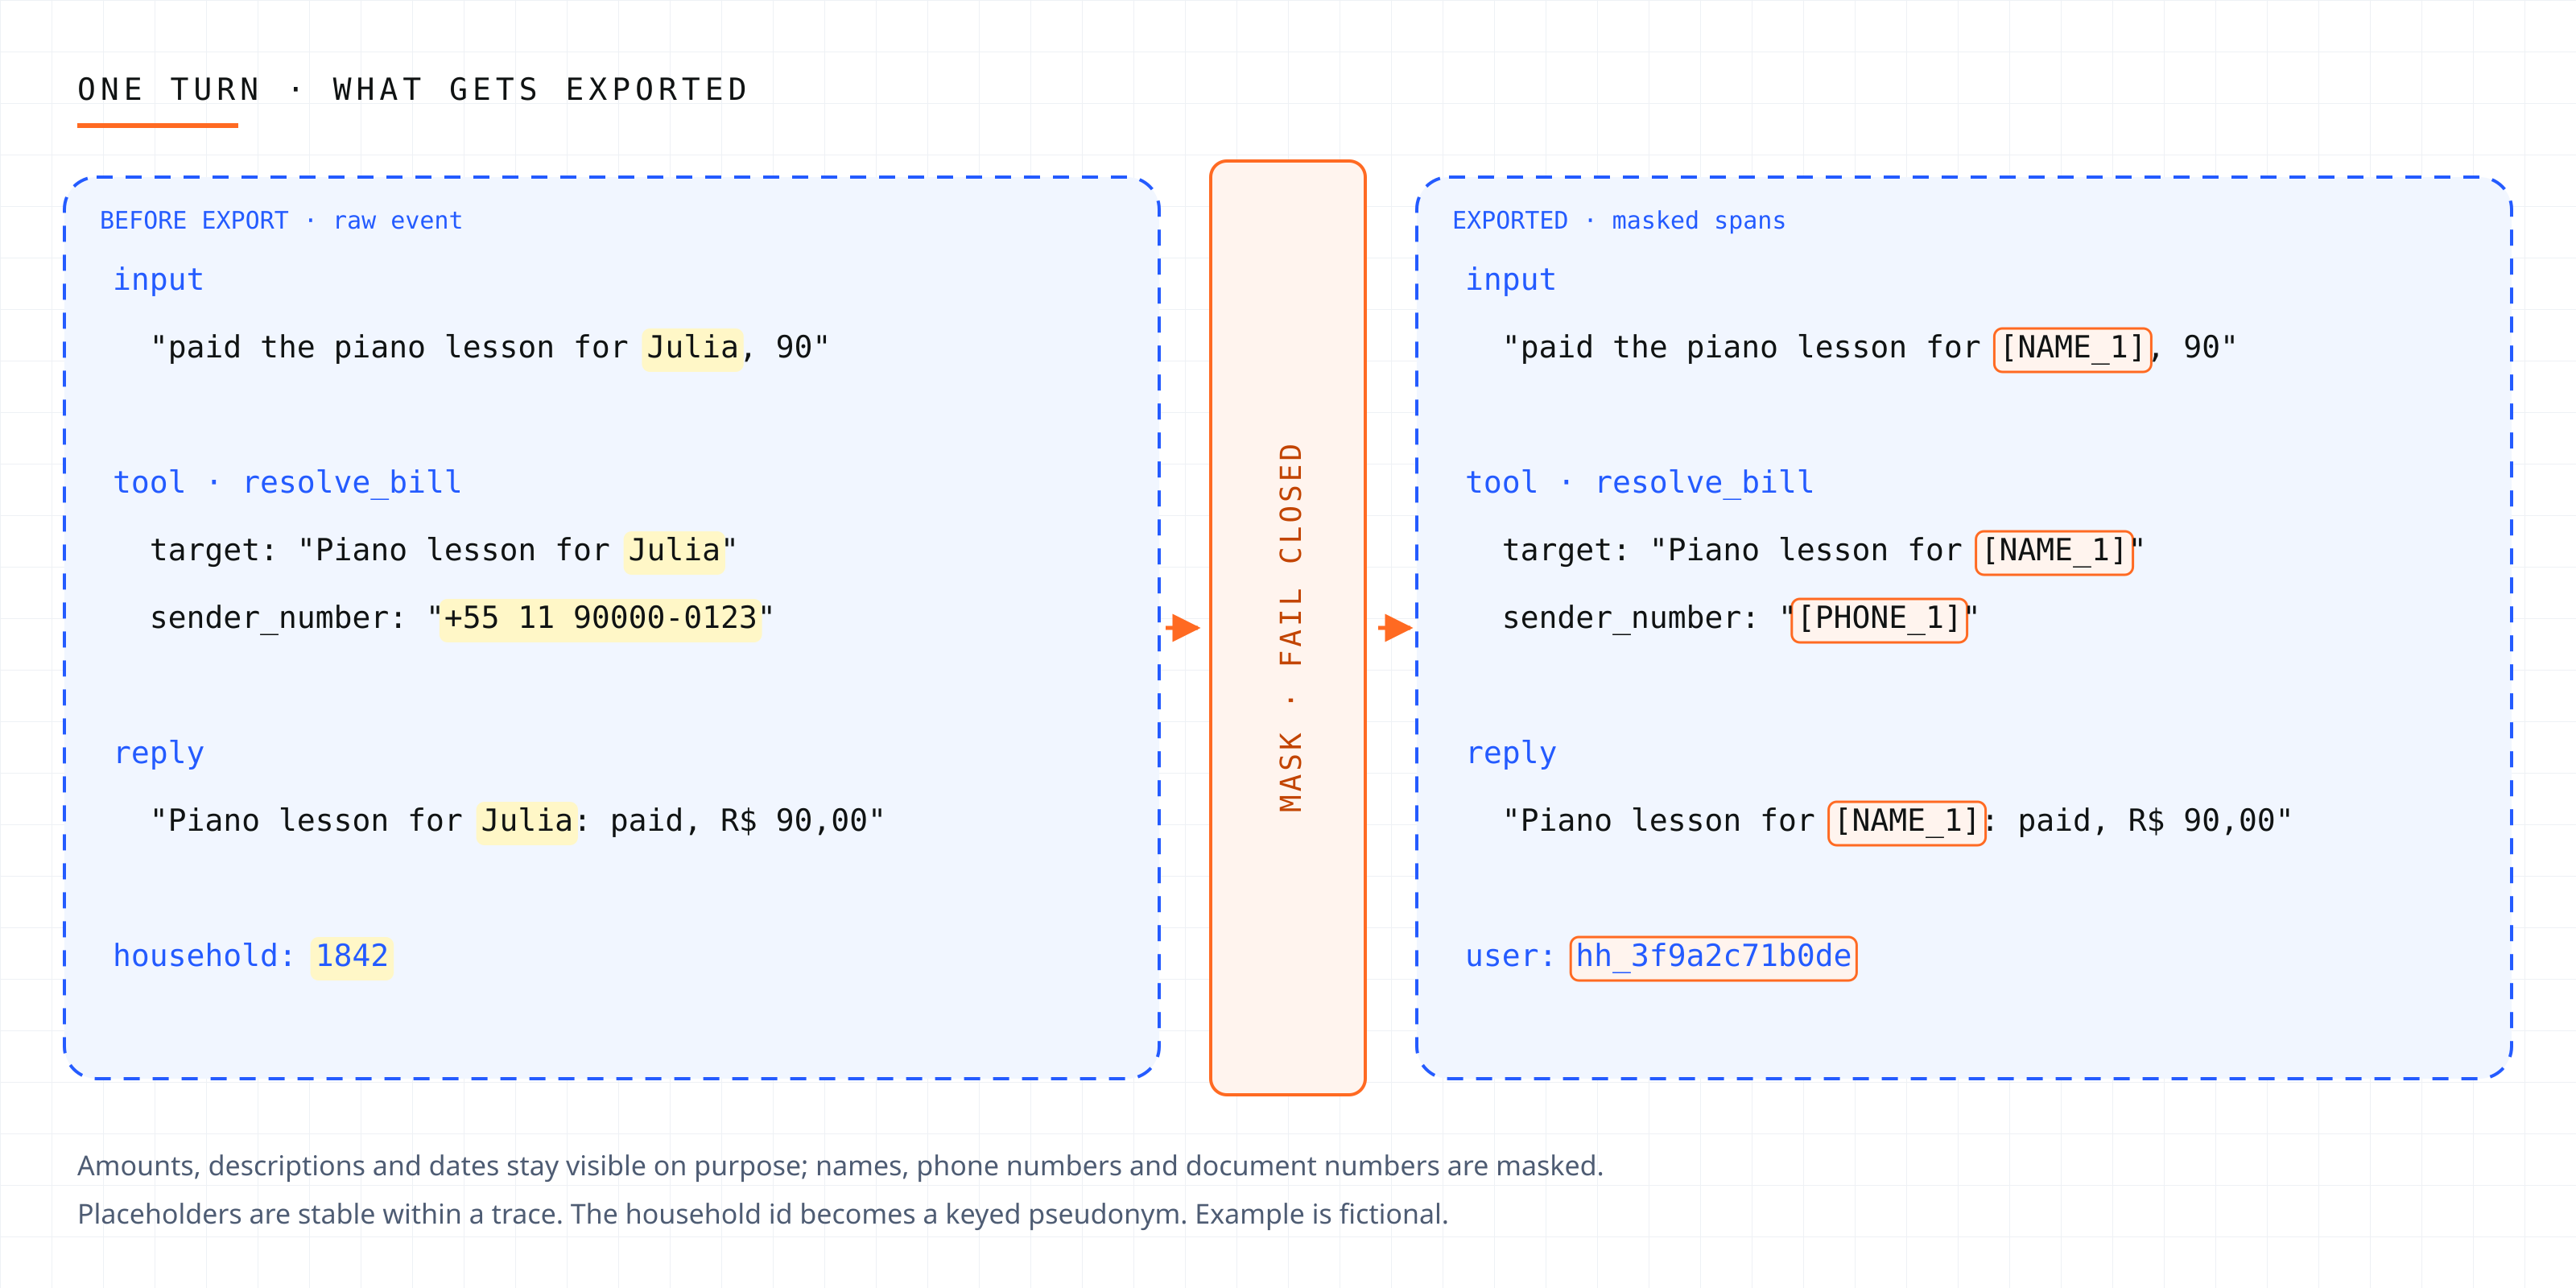
No hay modelo de aprendizaje automático detrás de la máscara. El reconocimiento de entidades añadiría una dependencia pesada, con fallos difíciles de reproducir en pruebas. La máscara es determinista y aplica tres capas en orden:
- nombres y teléfonos de los miembros del hogar, leídos de la base de datos;
- patrones validados: documentos fiscales brasileños con dígitos de control, tarjetas con comprobación Luhn, correos, códigos postales, direcciones y teléfonos;
- una lista de unos 3.000 nombres comunes y 1.000 apellidos.
Los marcadores son estables dentro de la traza: la misma persona siempre es [NAME_1]. El identificador del hogar se convierte en seudónimo HMAC con un secreto que nunca sale del servicio. La máscara falla de forma cerrada: cualquier valor no manejable o excepción pasa a [REDACTED].
Los errores se esconden en los patrones. Un formato de teléfono que omití, con un espacio tras el primer dígito del móvil, apareció en la revisión y ahora es una prueba. Y un precio como «R$ 11999,90» nunca debe parecer un teléfono, lo cual tiene su propia prueba.
Hay que dejar claro qué es y qué no es. El enmascaramiento elimina identificadores directos. No es anonimización. Importes, descripciones y fechas siguen visibles a propósito porque se necesitan para depurar un agente financiero; combinados de cierta forma, aún pueden revelar algo de un hogar. Los nombres ausentes de los datos de miembros y de la lista pueden pasar. El seudónimo protege el identificador del hogar de quien no tiene la clave, nada más.
Tras el despliegue, comprobé qué llegó a Langfuse. En las 18 observaciones exportadas que inspeccioné, la búsqueda de teléfonos, nombres y apellidos no encontró ninguno; encontró 20 marcadores en su lugar. Es evidencia de que la máscara funcionó en esos turnos, no prueba de que nunca falle.
Muestreo dentro del presupuesto
Langfuse mide el uso en unidades y cada turno consume algunas según el número de llamadas. La producción tiene presupuesto mensual; contamos el uso de nuestro lado porque consultarlo en Langfuse tiene límite de solicitudes.
Por debajo de una fracción de protección del presupuesto se aplica la tasa configurada. Por encima, la tasa disminuye para que la proyección del resto del mes entre en el presupuesto:
def effective_rate(configured, units_month, share, day, days_in_month):
    """Configured below the guard; above it, scale so the month ends within the share."""
    if units_month >= share:
        return Decimal(0)
    if units_month < GUARD_FRACTION * share:
        return configured
    daily = Decimal(units_month) / Decimal(max(day, 1))
    projected = daily * Decimal(max(days_in_month - day + 1, 1))
    guarded = (Decimal(share - units_month) / projected).quantize(_RATE_STEP, ROUND_DOWN)
    return min(configured, guarded)
Una tasa menor solo significa menos trazas detalladas. Las tablas de uso no dependen de ella.
En la exportación importa la semántica de entrega: un timeout no significa lo que parece. Cuando el job deja de esperar, la solicitud puede no haber salido, haber sido procesada por Langfuse o haber sido procesada con la respuesta perdida. El resultado es desconocido. Por eso la exportación nunca supone un fallo limpio. Las filas temporales solo se eliminan tras confirmar el lote; el resto permanece y se reenvía después. Para hacerlo seguro, los identificadores de trazas y spans se derivan de forma determinista del hogar y el turno: dos exportaciones llevan los mismos identificadores y llegan a las mismas observaciones sin crear otra traza. El cliente HTTP también tiene un plazo para terminar dentro de la espera del job, reduciendo llegadas tardías, aunque el diseño no depende de ello. Es entrega al menos una vez con identificadores idempotentes, no exactamente una vez.
Algunos fallos no merecen reintento. Si Langfuse rechaza un lote por formato o tamaño, reenviar los mismos bytes no ayuda. Se divide el lote por la mitad y se reenvía hasta aislar el turno rechazado. Ese turno se descarta y se registra en el log; el resto continúa.
Alertas
En Langfuse exploramos trazas individualmente. Pero preguntas como «¿cuánto cuesta cada hogar este mes?» necesitan un historial que permanezca en Lukre. Por eso la administración tiene una página propia de observabilidad que lee las tablas de uso y muestra coste por hogar, tiempo de respuesta, fallos y cuota.
No quiero quedarme mirando esa página. Un job periódico comprueba los números y me envía un mensaje de WhatsApp cuando se supera un límite:
- el presupuesto mensual de trazas se acerca al límite;
- la proporción de turnos fallidos supera el umbral, una vez que hay suficientes turnos para que un fallo no parezca una tendencia;
- las respuestas más lentas tardan más de lo debido;
- el coste diario supera el límite o un hogar cuesta varias veces más que el típico.
Los mensajes usan la misma cola que los recordatorios, como máximo uno por tipo de alerta al día, para que una mala tarde no genere cincuenta notificaciones. Los límites se ajustan en la administración.
Lo que mostraron las trazas sobre el coste
Esta parte confirmó lo que esperaba, con números.

Una llamada de producción con caché caliente, desglosada. Costes estimados por el número de tokens y los precios por token del modelo.
Cada viaje al modelo reenvía todo el contexto: instrucciones, persona, definiciones de herramientas e historial de sesión. En la llamada desglosada hubo 168.464 tokens de entrada, de los cuales 167.936 vinieron de la caché de prompts del proveedor. Solo 528 eran nuevos. En un agente con herramientas, ahí iba a estar el coste. La buena noticia: la caché ya hacía su trabajo. Los tokens en caché cuestan una décima parte del precio normal de entrada, manteniendo la llamada en unos US$ 0,0045 aunque el 93% se destinase al contexto.
Ese 93% describe una llamada, no el sistema. Otras llamadas con caché tenían entre unos 167.000 y 183.000 tokens de contexto y las del mismo turno costaban a pocas décimas de centavo de ella, lo que sugiere el mismo patrón. Pero solo desglosé esta. El contraste con caché fría es más claro: la primera llamada tras reiniciar Hermes, sin caché en el proveedor, costó US$ 0,042, casi diez veces más. Es una observación única, pero coincide con la tarificación.

Un turno de producción. Cada resultado de herramienta exige otro viaje al modelo con todo el contexto.
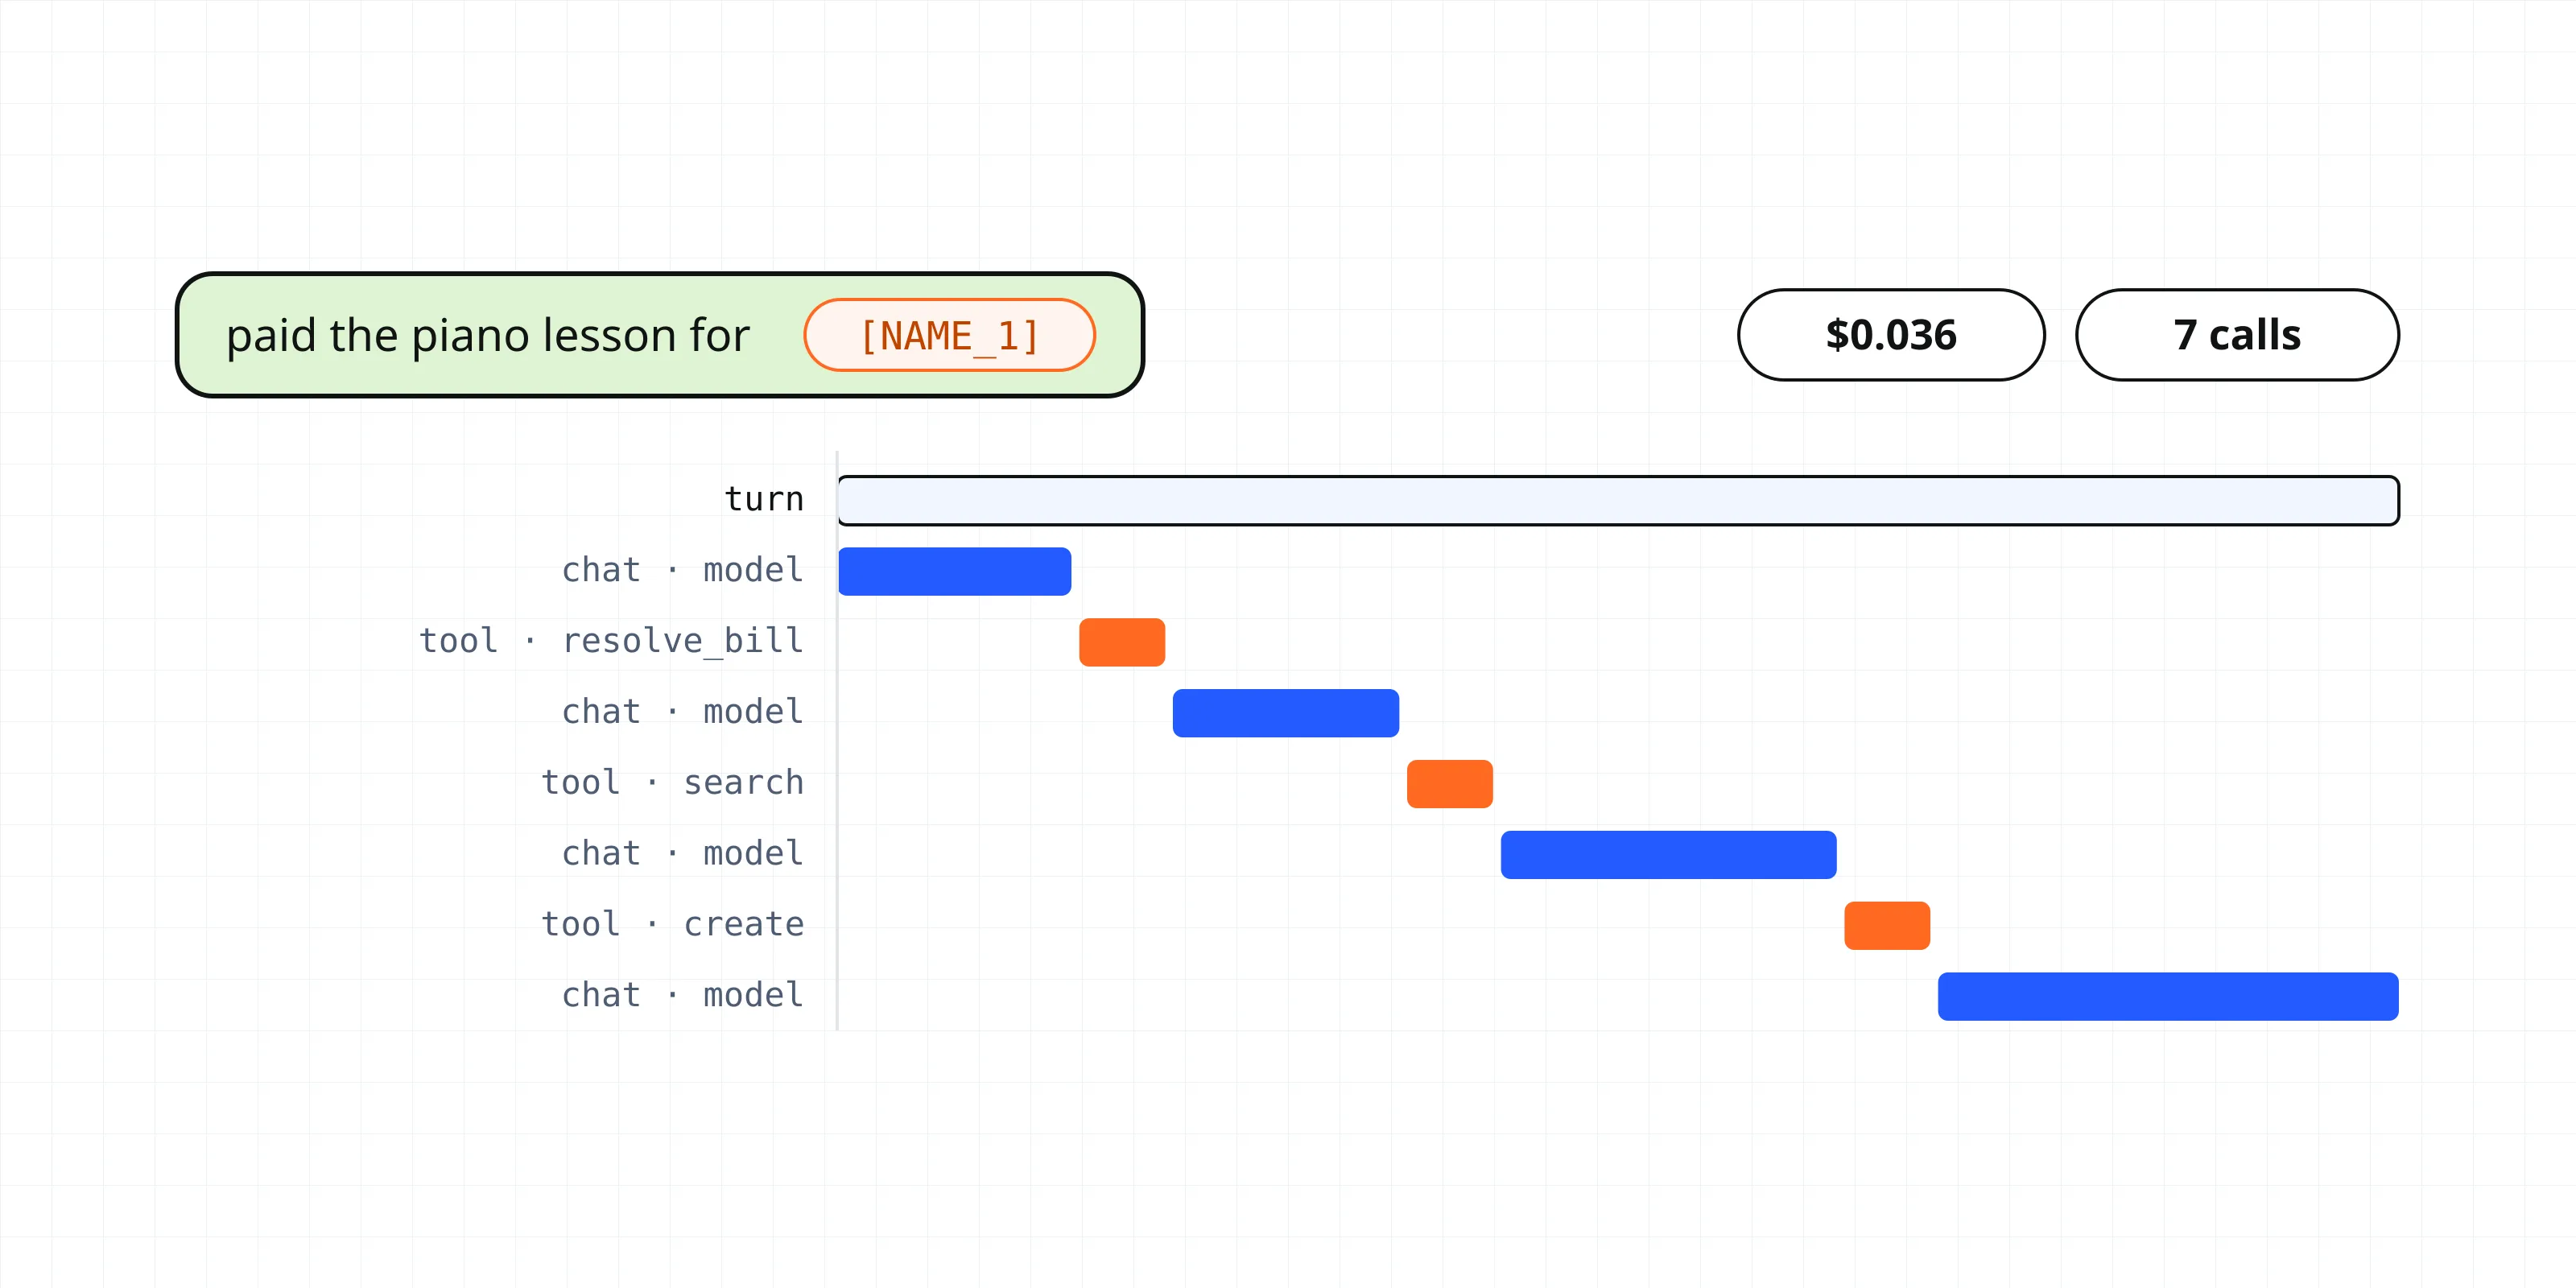
Un turno intenso usó seis herramientas y siete llamadas de modelo por US$ 0,036. El coste sigue el número de viajes al modelo, no la longitud del mensaje. La llamada tras list_recurring recibió unos 11.000 tokens nuevos de salida de herramienta y costó un 60% más que las vecinas.
El ahorro, cuando llegue, estará en la ingeniería de contexto, no en prompts más cortos para el usuario: contexto fijo menor, menos viajes al modelo por mensaje y herramientas con resultados más ligeros. Nada de eso está hecho todavía. Ahora, al menos, podré medirlo cuando lo esté.
El laboratorio de evaluación
La segunda mitad del trabajo fue un laboratorio para responder a la pregunta del artículo anterior: ¿un cambio mejora o empeora al agente?
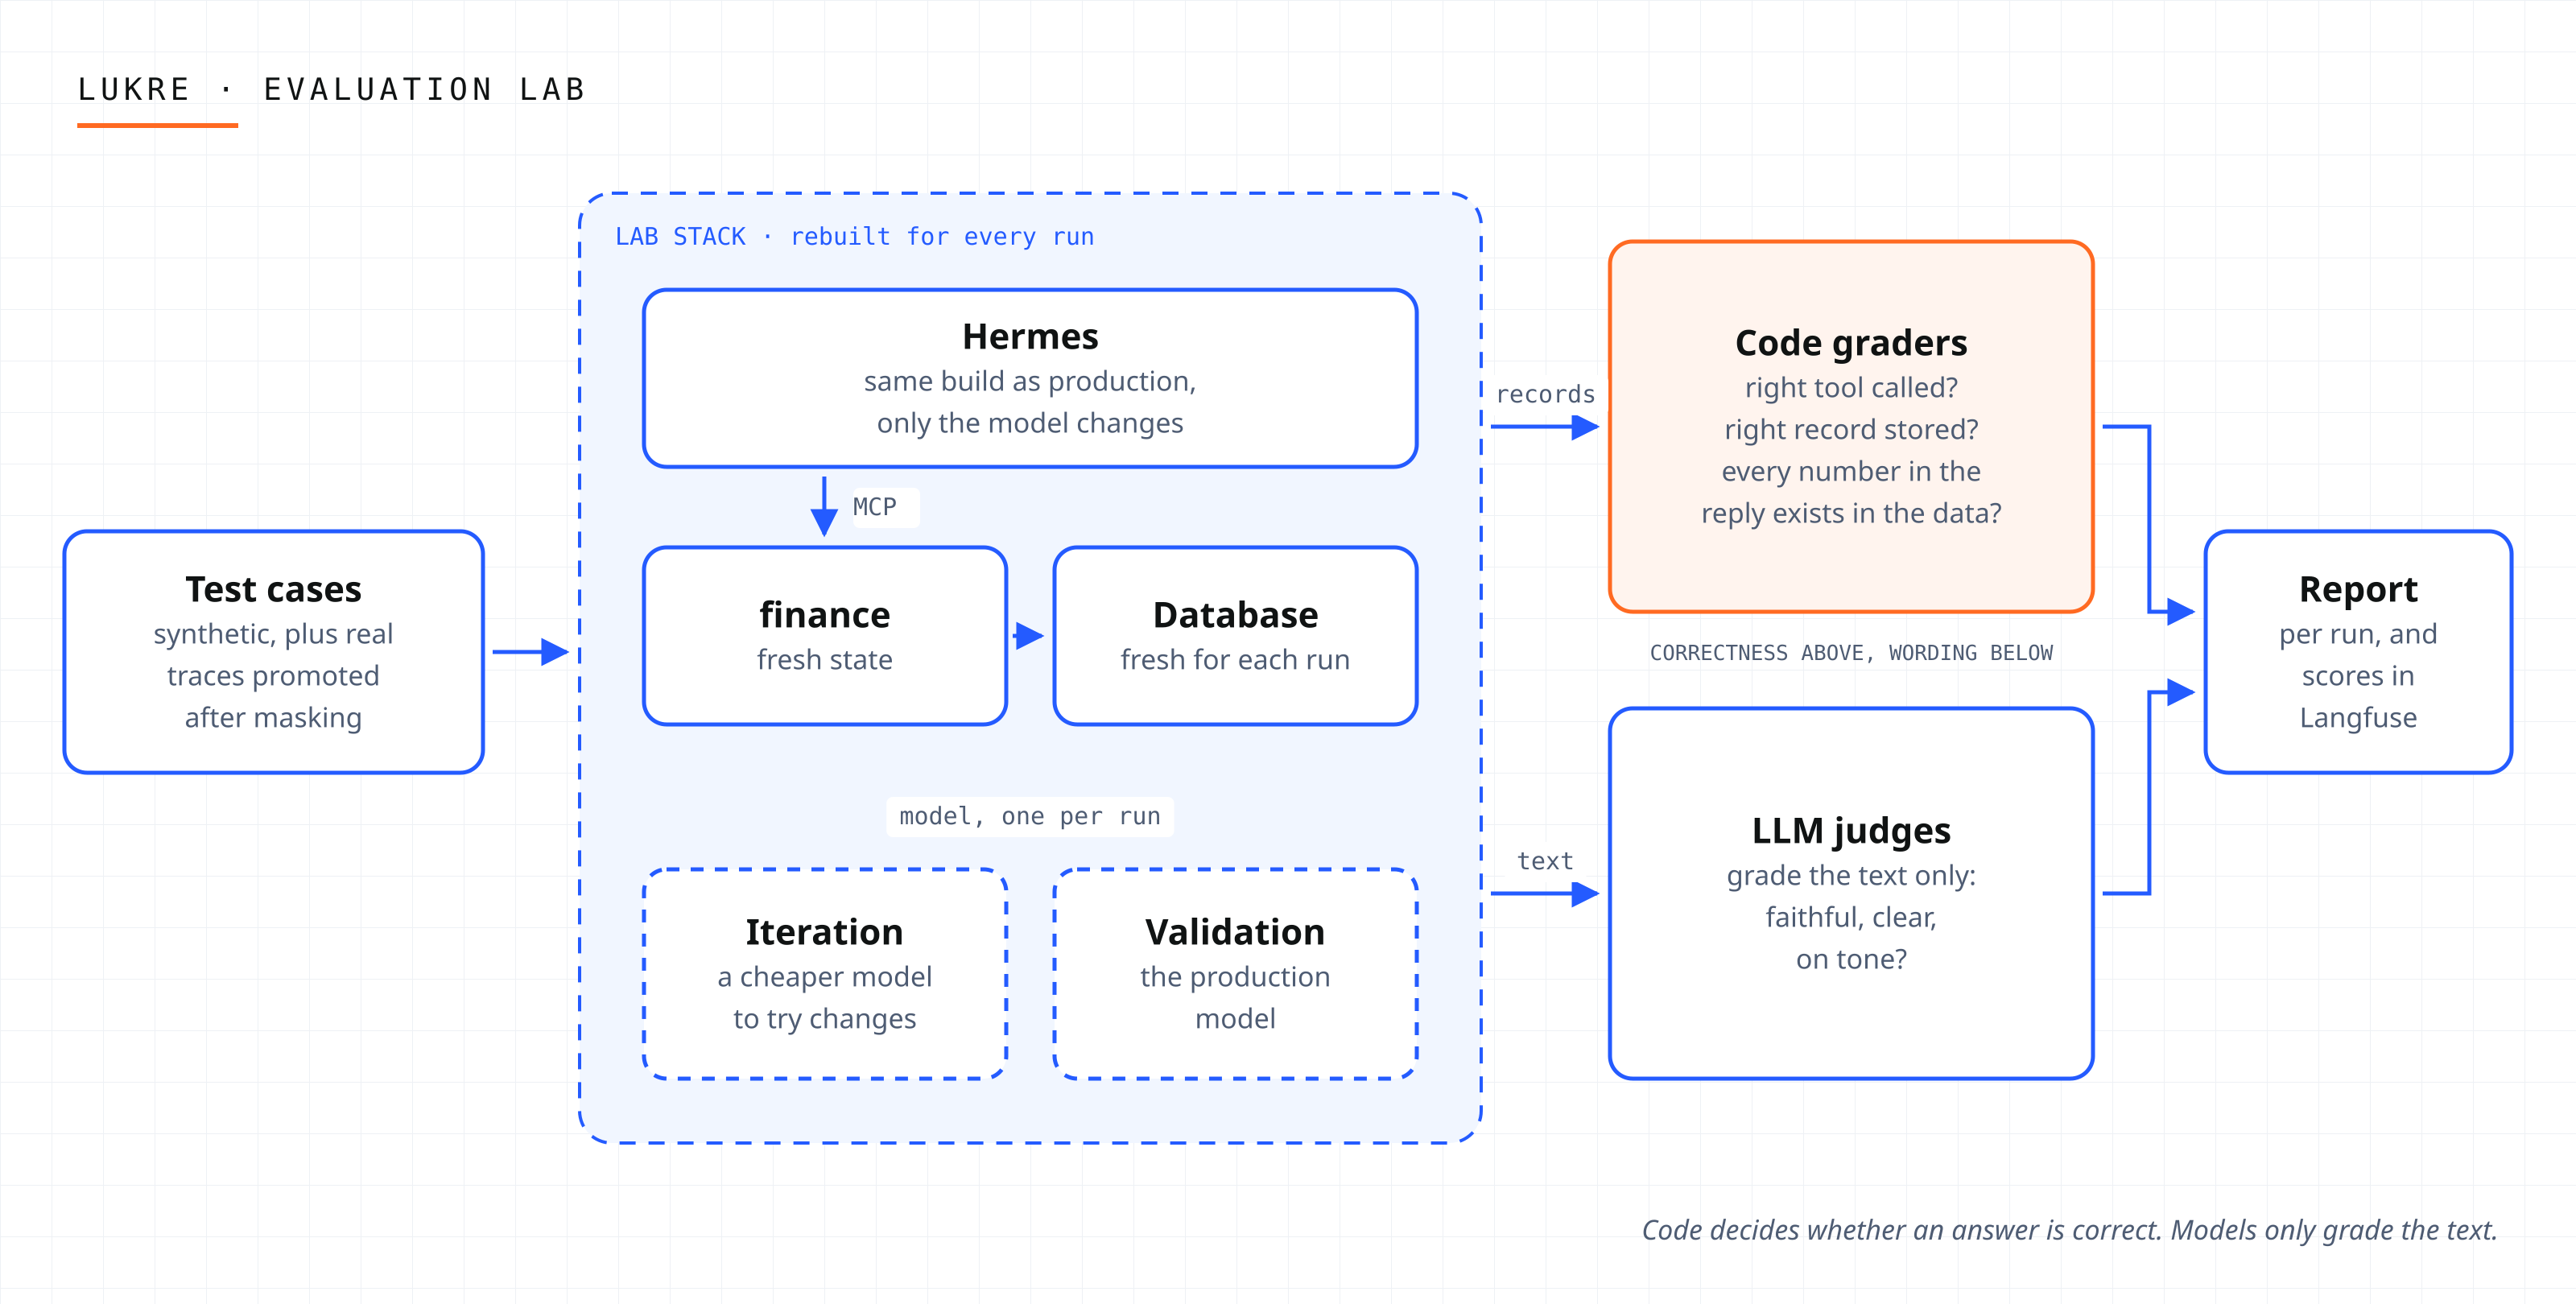
Dos decisiones lo definen:
- El mismo agente de producción. El laboratorio usa la versión de producción de Hermes con la plantilla de perfil de producción y una base de datos nueva por ejecución. Solo cambia el modelo. Un laboratorio con otro agente mide otro agente.
- El código decide, los modelos opinan. Si se llamó a la herramienta correcta, si el registro tiene importe, tipo y categoría correctos y si todos los números de la respuesta existen en los datos son comprobaciones de código, leyendo la base de datos tras el turno. Los jueces LLM solo evalúan el texto: fidelidad, claridad y tono.
Las conversaciones reales también pueden convertirse en casos. Un comando transforma una traza de producción, ya enmascarada, en caso de prueba, que queda fuera de las ejecuciones hasta que alguien escriba el resultado esperado.
La primera validación usó cinco casos sintéticos de captura y el modelo de producción. Los cinco registros fueron correctos y la ejecución costó US$ 0,024. Cinco casos sintéticos son una prueba básica, no una medida de precisión: muestran que laboratorio, evaluadores e informes funcionan de extremo a extremo en esos casos. Aún no dicen lo bueno que es el agente ante lo que envían hogares reales. Eso exige más casos y recorridos.
Cómo se hizo el trabajo
El proceso merece unas líneas, porque forma parte de cómo trabajo hoy.
Todo empezó con una investigación de viabilidad: leer los hooks de Hermes, probar el plugin incluido y experimentar con Phoenix. Después vinieron un documento de requisitos con historias de usuario, una especificación técnica y 14 registros de decisiones arquitectónicas, cada uno con contexto, alternativas y consecuencias. La especificación incluía un contrato de las pruebas que escribir antes de que existiera código.
La implementación se dividió en ocho tareas con grafo de dependencias y se ejecutó mediante agentes en paralelo, en tres oleadas. La revisión señaló 20 problemas: uno crítico, cinco altos, diez medios y cuatro bajos; todos se corrigieron. Varios detalles de este artículo, del patrón de teléfono a la división de lotes rechazados, vinieron de esa revisión. Las suites unitarias y del plugin suman ahora más de 2.900 pruebas.
Los números y sus límites
Los costes proceden de pocos turnos de producción el día del despliegue y son estimaciones por número de tokens y precios unitarios. Los tiempos de respuesta estuvieron entre 6,2 y 6,5 segundos por turno en esa pequeña muestra. Las cifras del laboratorio vienen de cinco casos sintéticos, revisados por un modelo de IA, no por mí. Muestran que los instrumentos funcionan. No son un benchmark; prefiero decirlo aquí a que el lector lo descubra.
Qué viene después
Tengo un cambio en la lista. Hoy, el paso del agente al servicio financiero usa una cola en memoria drenada por un hilo. Nunca retrasa respuestas, pero pierde eventos pendientes al reiniciar y lotes cuyo envío falla. Ambos se cuentan, no se recuperan. Un broker entre ambos haría duradero ese paso y permitiría múltiples consumidores de los mismos eventos. También sería otro servicio que operar y observar, por lo que debe justificar su lugar. Esa es la próxima decisión y, como las otras, tendrá su propio ADR.
Siguiendo el dinero
Lukre existe para responder a una pregunta del hogar: ¿adónde fue el dinero? Supermercado, factura de luz, aplicación de comida a domicilio que nadie admite usar.
La observabilidad hizo la misma pregunta al propio Lukre y la respuesta parecía un extracto doméstico: una línea mucho mayor que las demás. En un hogar suele ser la comida a domicilio. En Lukre, en la llamada que desglosé, eran 167.936 tokens de contexto en caché, reenviados en cada viaje al modelo y responsables del 93% de la cuenta.
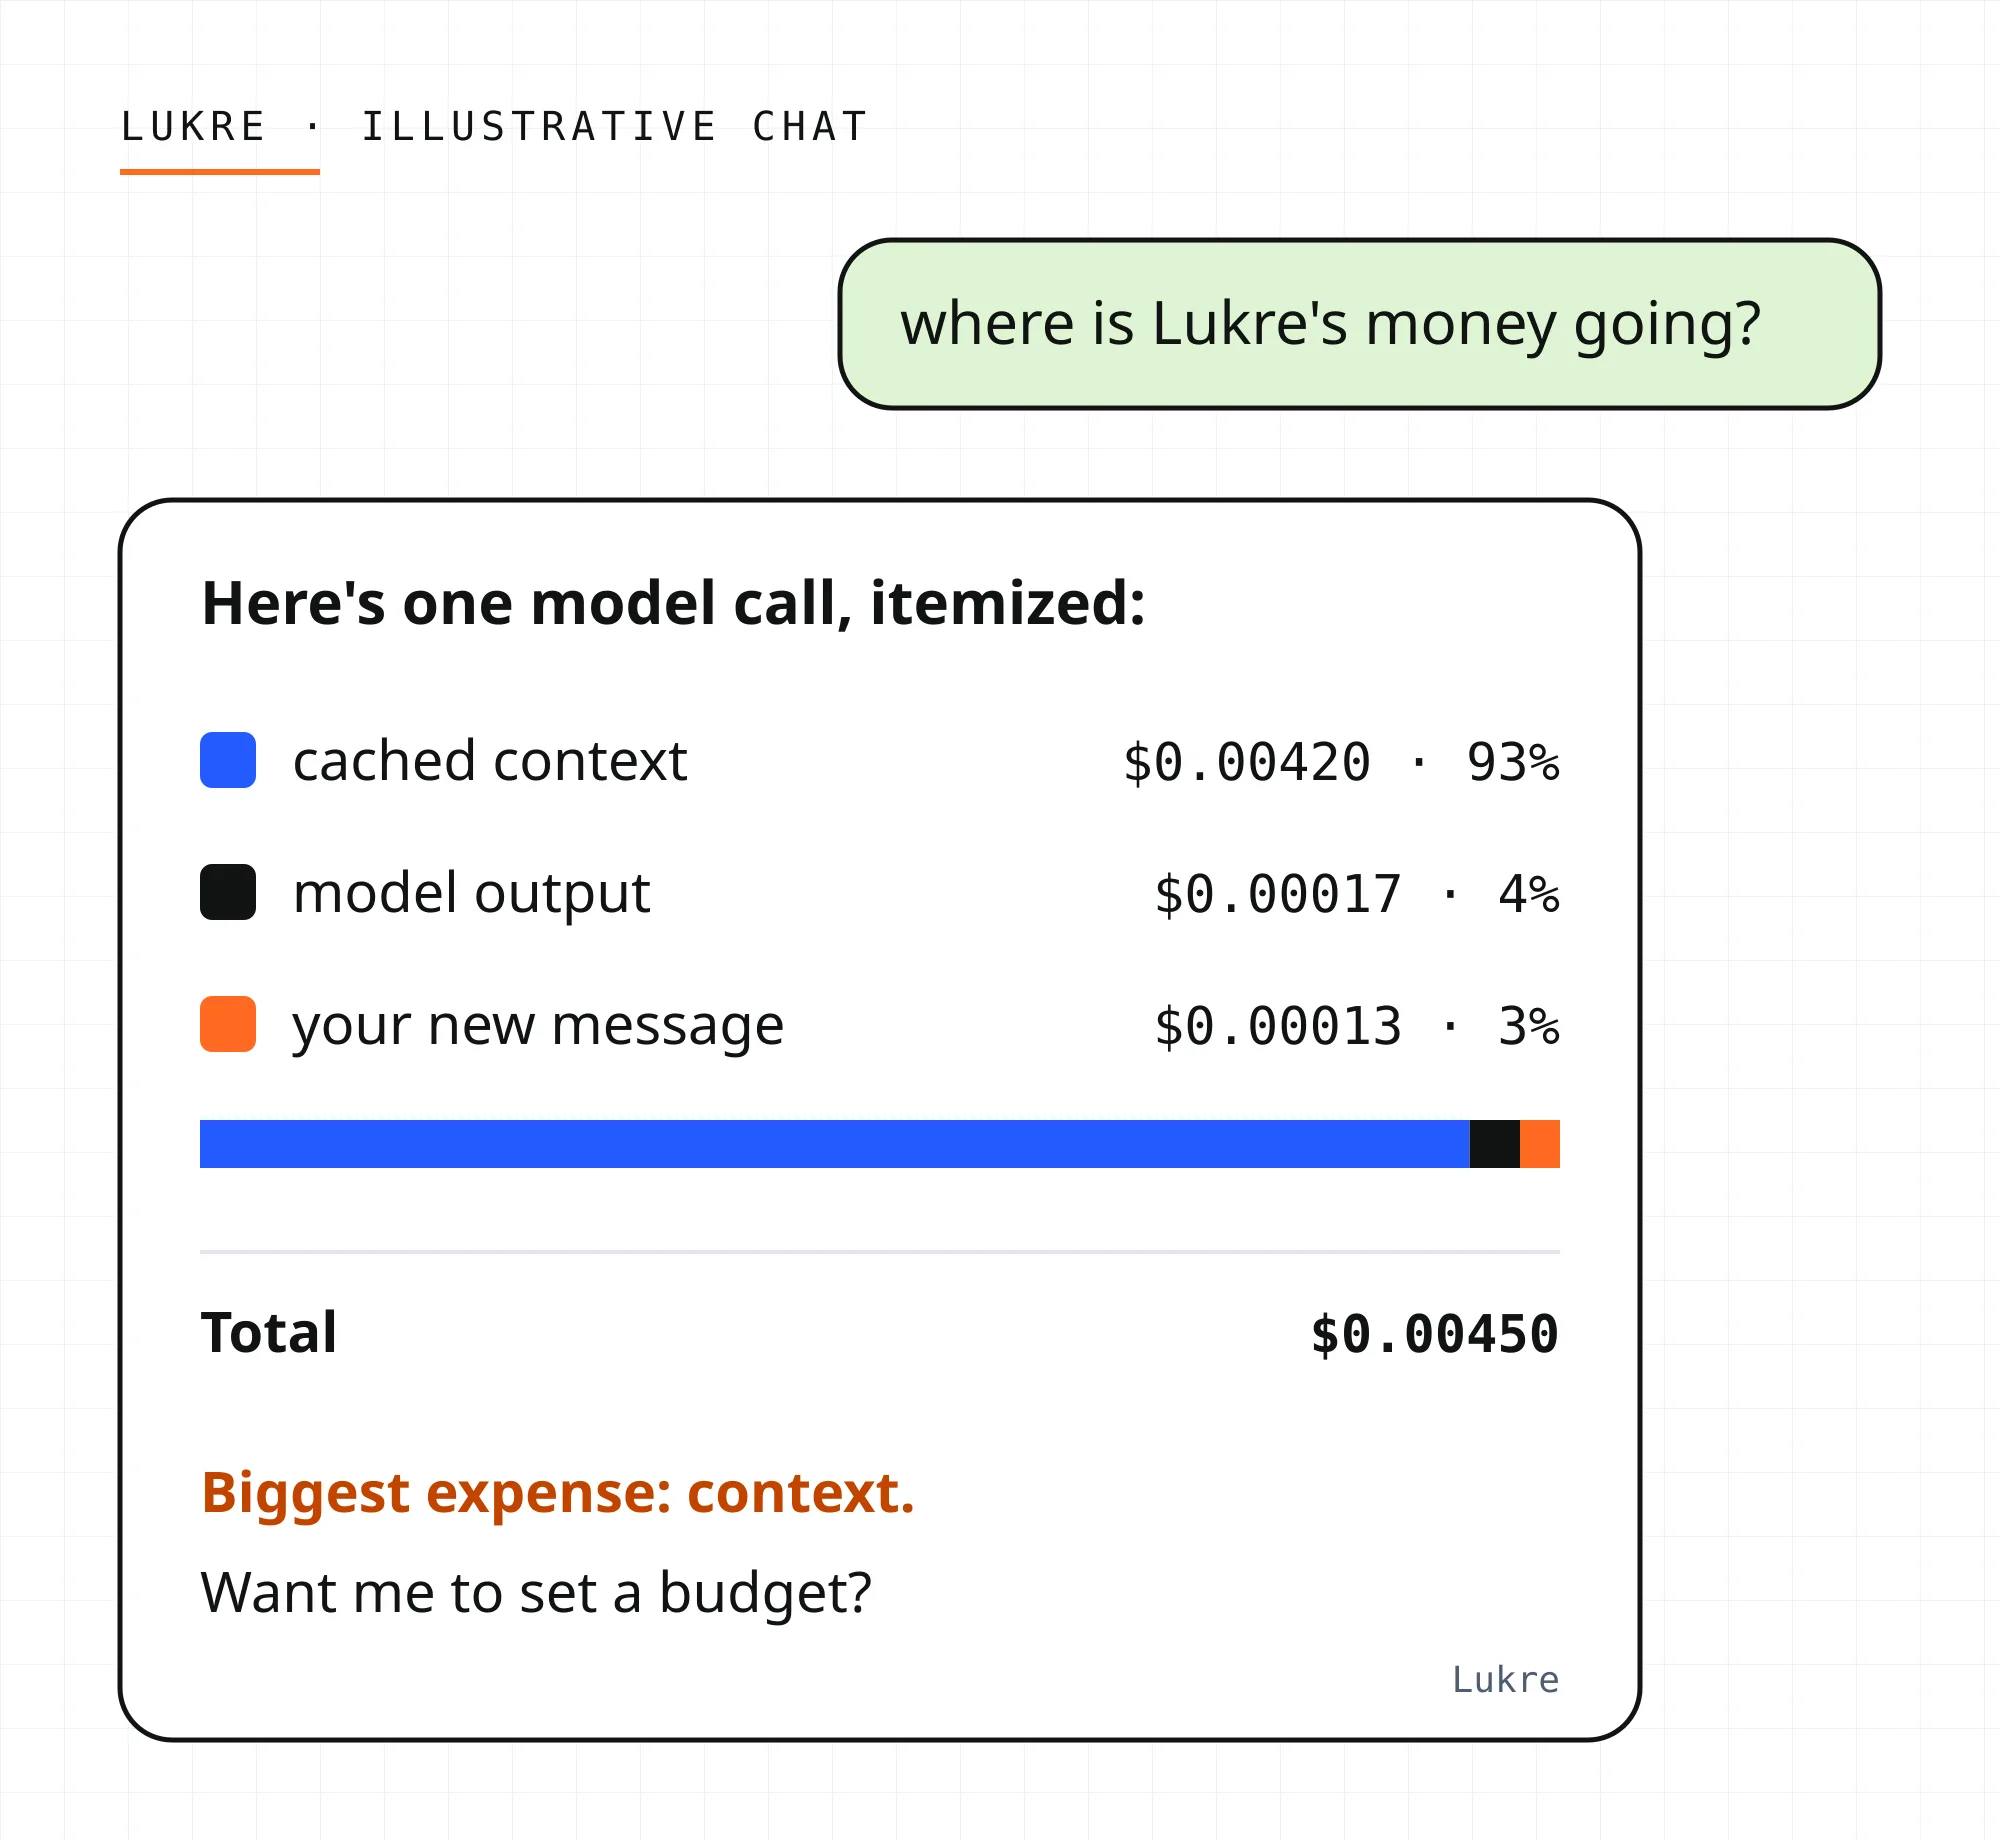
Conversación ilustrativa. El desglose es el coste estimado de una llamada de producción.
Ahora Lukre tiene su propio extracto. El siguiente paso es el que conoce cualquier hogar: recortar el gasto que estaba a plena vista.
Puedes conocer Lukre y lo que hace o leer cómo se construyó en Construyendo Lukre.